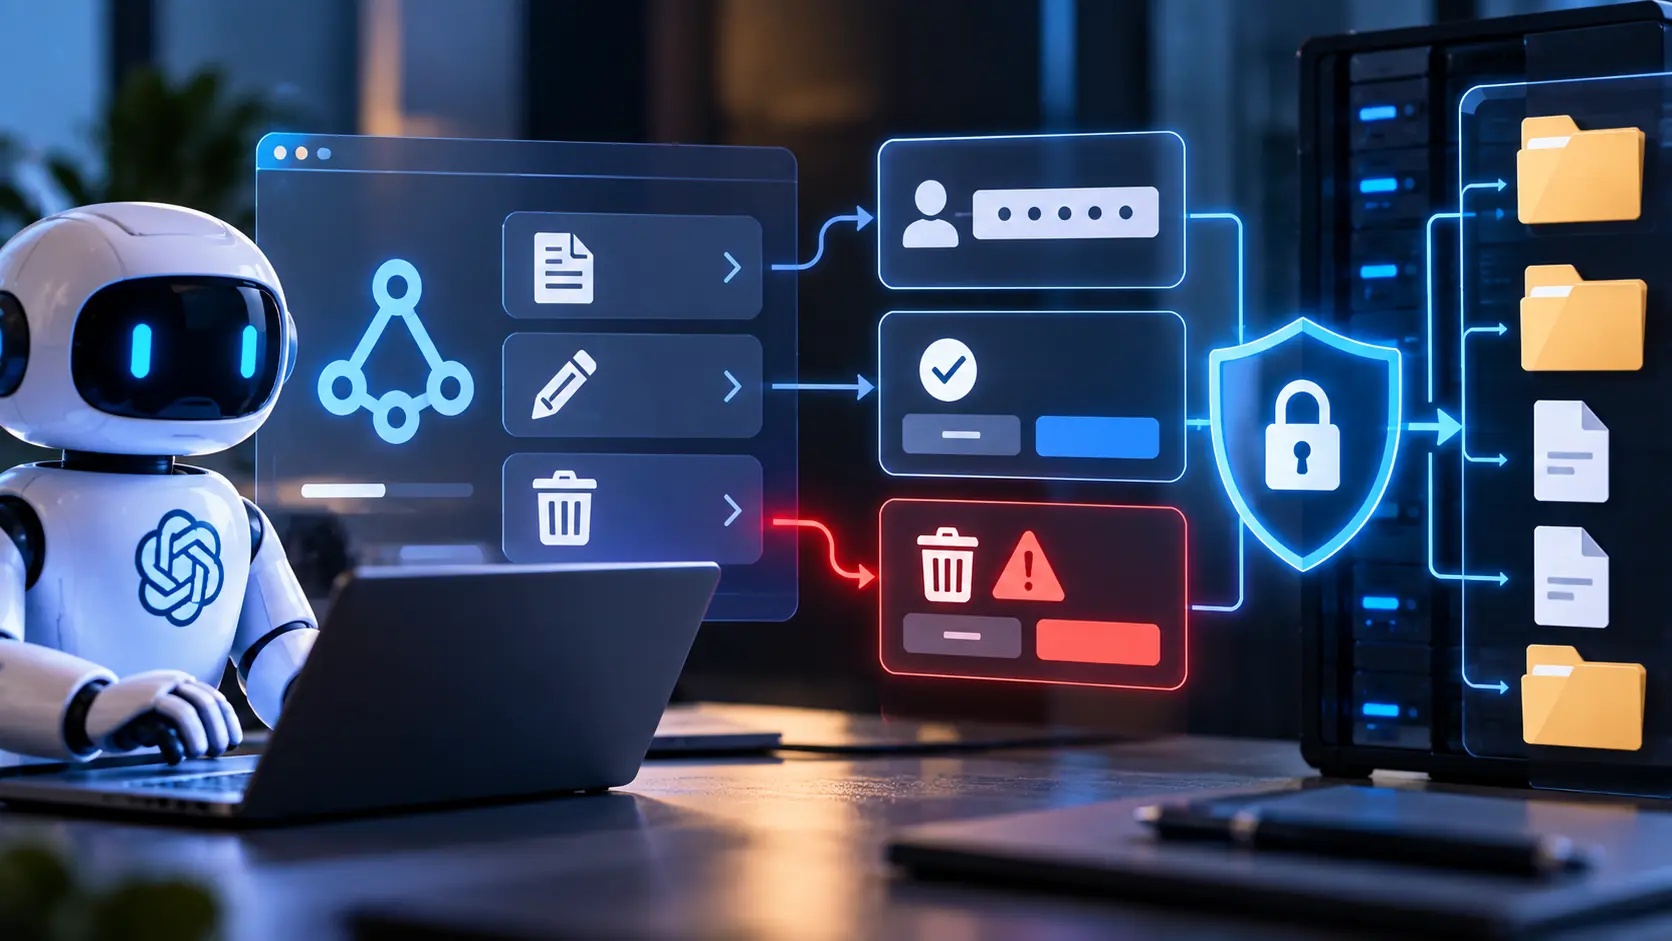
MCP Toolでは、データを読むだけでなく、外部システムを変更する処理も実装できます。たとえば、delete_customer・update_issue・send_email・deploy_application・cancel_orderといったToolです。
AIエージェントにとって非常に便利な機能ですが、検索や読み取りToolと同じ感覚で実装すると危険です。モデルがIDを取り違えたり、Prompt Injectionによって誤った操作を選択したり、通信の再試行によって同じToolが複数回実行されたりすると、実データが失われる可能性があります。
特に、delete(id)だけを受け取って即座に削除するToolは避けたほうがよいでしょう。
安全な破壊的Toolでは、次のような複数段階の設計を考えます。
対象を特定
  ↓
現在状態を確認
  ↓
変更内容をPreview
  ↓
必要ならユーザー確認
  ↓
権限を再確認
  ↓
更新・削除
  ↓
結果を検証
  ↓
監査ログを残す
現在のMCPには、Toolの性質をClientへ伝えるreadOnlyHint、destructiveHint、idempotentHintなどのAnnotationがあります。しかしMCP Python SDKの公式ドキュメントも、これらはあくまでClient向けのHintであり、Security機構ではないと明記しています。Clientが確認画面を出してくれることを前提にしてはいけません。
この記事では、MCP Toolに削除や更新などの破壊的操作を持たせる場合に、誤操作や二重実行を防ぐための設計方法を解説します。
- destructiveHintで破壊的Toolだと明示する
- AnnotationをAccess Controlとして使わない
- deleteとupdateを巨大なmanage Toolへまとめない
- 「confirm=true」を引数に入れるだけでは確認にならない
- ユーザー確認はモデル入力とは別の経路で取る
- 2026-07-28では確認処理の再実行にも注意する
- Preview Toolと実行Toolを分ける
- 確認Tokenを発行する方法もある
- 確認Tokenには有効期限を付ける
- 更新Toolにはexpected_versionを持たせる
- update_customerに現在値も渡させる方法がある
- 削除はHard DeleteよりSoft Deleteを優先する
- deleteとrestoreを対にする
- idempotentHintは実装が本当に冪等な場合だけtrueにする
- 削除Toolも冪等に設計できる
- PaymentやEmail送信にはIdempotency Keyを使う
- 「delete_all」のような広すぎるToolを避ける
- 自然言語だけで対象を指定させない
- Prompt Injectionを前提にServer側で権限確認する
- Tool Descriptionにも副作用を具体的に書く
- update Toolでは変更可能FieldをAllowlistする
- JSON SchemaのValidationだけではBusiness Ruleを保証できない
- Database更新はTransactionでまとめる
- 外部APIを含む場合はRollbackできない前提で設計する
- 失敗時に「再実行してください」だけ返さない
- 結果には変更後の状態を返す
- 削除後に存在確認する
- 監査ログを残す
- BeforeとAfterを保存すると調査しやすい
- dry-runを用意する
- 本番Environmentはさらに権限を分離する
- 削除できる件数をServer側で制限する
- Tool Annotation・Confirmation・Permissionはそれぞれ役割が違う
- MCPの破壊的Tool設計に関するよくある質問
- MCPの破壊的Toolは「実行できる」より「間違って実行されても壊れにくい」を目指す
destructiveHintで破壊的Toolだと明示する
MCP Toolにはannotationsを設定できます。削除Toolなら、たとえばPython SDKで次のようにできます。
from mcp.server import MCPServer
from mcp.types import ToolAnnotations

mcp = MCPServer("Customers")


@mcp.tool(
    annotations=ToolAnnotations(
        read_only_hint=False,
        destructive_hint=True,
        idempotent_hint=True,
        open_world_hint=False,
    )
)
def delete_customer(
    customer_id: str
) -> str:
    ...
read_only_hint=Falseは状態を変更するToolであることを示します。destructive_hint=Trueは、既存データを削除したり破壊的に更新したりする可能性があることを示します。idempotent_hint=Trueは、同じ引数で繰り返し実行しても追加の副作用が発生しないToolであることを示します。
現行MCP TypeScript SDKでは、destructiveHintのDefaultはtrue、idempotentHintのDefaultはfalseです。またこれらはreadOnlyHint == falseの場合に意味を持ちます。
AnnotationをAccess Controlとして使わない
たとえば、destructiveHint=trueにしておけばClientが必ず確認画面を出す、と考えるのは危険です。
MCP Python SDKの公式ドキュメントでは、ClientがAnnotationを見て「実行前にユーザーへ確認するか」といった判断に利用できる一方、AnnotationはSecurityではなく、Clientが従うことを前提にしてはいけないと説明されています。
つまり、destructiveHintは、このToolは危険ですとClientへ知らせるMetadataです。実際に、そのUserに削除権限があるか、そのResourceを削除してよいか、ユーザー確認が済んでいるかを保証するのはMCP Server側です。
deleteとupdateを巨大なmanage Toolへまとめない
たとえば、次のようにget・create・update・deleteを1つのToolにまとめることもできます。
@mcp.tool()
def manage_customer(
    action: str,
    customer_id: str,
    data: dict | None = None
):
    ...
しかしAIモデル向けでは、処理の危険度が分かりにくくなります。読み取りと削除を分けて、get_customer・update_customer・delete_customerとしたほうが、モデルにもClientにも副作用が明確になります。
特にget_customerにはreadOnlyHint=trueを付け、delete_customerにはreadOnlyHint=false・destructiveHint=trueを付けられます。Tool単位でPermissionやScopeを分けることも容易になります。
「confirm=true」を引数に入れるだけでは確認にならない
削除Toolを安全にしようとして、次のようにすることがあります。
@mcp.tool()
def delete_customer(
    customer_id: str,
    confirm: bool
):
    if not confirm:
        return "Confirmation required"

    ...
しかしこれは強い確認にはなりません。なぜなら、{"customer_id": "123", "confirm": true}を作るのもAIモデル自身だからです。モデルが「削除するにはconfirm=trueが必要」と理解すれば、自分でtrueを設定できます。これは人間の確認ではありません。
ユーザー確認はモデル入力とは別の経路で取る
MCP Python SDKでは、Elicitationを利用してUser Inputを取得できます。現在のSDKには、破壊的操作を確認する具体例として、Directory削除前に確認を行うResolverが掲載されています。
重要なのは、確認値がToolのInput Schemaへ出ないことです。Clientやモデルが渡すのはpathだけで、確認結果はResolver側からToolへ注入されます。概念的には次のようにできます。
from typing import Annotated

from pydantic import BaseModel

from mcp.server import MCPServer
from mcp.server.mcpserver import (
    Elicit,
    Resolve,
)

mcp = MCPServer("Customers")


class ConfirmDelete(BaseModel):
    ok: bool


async def confirm_delete(
    customer_id: str
) -> ConfirmDelete | Elicit[ConfirmDelete]:

    customer = load_customer(
        customer_id
    )

    return Elicit(
        (
            f"{customer['name']} "
            "を削除しますか?"
        ),
        ConfirmDelete,
    )


@mcp.tool()
async def delete_customer(
    customer_id: str,
    confirmation: Annotated[
        ConfirmDelete,
        Resolve(confirm_delete)
    ],
) -> str:

    delete_from_database(
        customer_id
    )

    return "deleted"
この場合、モデルはconfirmation=trueを勝手に生成できません。確認処理はTool本体より前にResolverによって実行されます。
2026-07-28では確認処理の再実行にも注意する
2026-07-28 MCPでは、ServerからClientへの従来型JSON-RPC Request Channelがなくなり、追加のUser Inputが必要な場合はinput_requiredを返し、Clientが回答を付けて元のCallを再実行するMulti Round-Trip方式になっています(この変更の詳細はMCPのtools・resources・promptsの違いで解説しています)。
Python SDKのResolverはこの違いを吸収しており、2026-07-28でもLegacy Clientでも同じ形で利用できます。ここで重要なのは、確認前に副作用を発生させないことです。
たとえば次の順序は危険です。
Databaseを更新
  ↓
input_requiredを返す
  ↓
ユーザーへ確認
  ↓
Tool Callが再実行
Multi Round-TripではHandlerが再度実行されるため、更新処理が複数回走る可能性があります。必ず、確認→権限確認→副作用の順にします。
確認
  ↓
権限確認
  ↓
副作用
Preview Toolと実行Toolを分ける
特に影響の大きい操作では、PreviewとExecutionを分ける方法が有効です。たとえば最初にpreview_delete_customerを呼び出します。
{
  "customerId": "123",
  "name": "Example Corp",
  "orders": 48,
  "invoices": 12,
  "canDelete": true
}
モデルやユーザーが影響を確認した後、delete_customerを実行します。こうすれば、IDだけを見て即削除する構成を避けられます。
確認Tokenを発行する方法もある
Previewと実行をより強く結び付けるなら、Serverが確認Tokenを発行する方法があります。たとえばPreview Toolが次を返します。
{
  "customerId": "123",
  "version": 18,
  "confirmationToken": "opaque-token..."
}
削除Toolでは次を要求します。
{
  "customerId": "123",
  "confirmationToken": "opaque-token..."
}
TokenにはServer側で、User ID・Resource ID・Action・Resource Version・Expirationを紐付けておきます。Tokenはモデルが自由に生成できる文字列ではなく、Serverが発行した署名付き、またはServer-side Storageと対応するOpaque Tokenにします。
これにより、Customer 123の削除確認をした後に別のCustomer 456を削除する、といった取り違えを防ぎやすくなります。
確認Tokenには有効期限を付ける
Preview後、数時間経ってから削除を実行すると、その間にデータが変化している可能性があります。そこで確認Tokenは短時間(5分・10分程度)で失効させます。
さらにTokenにResource Versionを関連付けておけば、次のような制御ができます。
Preview時 version=18
  ↓
別Userが更新
  ↓
現在 version=19
  ↓
削除拒否
確認した状態と実行時の状態が違うなら、もう一度Previewさせるほうが安全です。
更新Toolにはexpected_versionを持たせる
削除だけでなく更新でも問題になります。たとえばモデルがCustomerを取得します。
{
  "id": "123",
  "email": "old@example.com",
  "version": 18
}
その直後、人間が同じCustomerを更新してversion=19になったとします。AIが古い情報のまま更新すると、人間の変更を上書きする可能性があります。そこで更新Toolへexpected_versionを渡します。
@mcp.tool()
def update_customer(
    customer_id: str,
    email: str,
    expected_version: int,
):
    ...
Databaseでは概念的に次のようにします。
UPDATE customers
SET
    email = :email,
    version = version + 1
WHERE
    id = :customer_id
    AND version = :expected_version;
更新件数が0なら、対象が変更されています。最新状態を再取得してください。と返します。これはOptimistic Lockingと呼ばれる一般的なConcurrency Controlです。AIエージェントでは「少し前に読んだ情報」をもとにToolを呼ぶことが多いため、特に相性のよい対策です。
update_customerに現在値も渡させる方法がある
Version Columnを追加できないシステムなら、old_email・new_emailのように現在値をPreconditionとして渡す方法もあります。
UPDATE customers
SET email = :new_email
WHERE
    id = :id
    AND email = :old_email;
すでに別の値へ変わっていれば更新しません。モデルが「以前読んだ状態」と「現在の状態」の差を無視して上書きする事故を防げます。
削除はHard DeleteよりSoft Deleteを優先する
可能なら、次のようなHard Deleteより、
DELETE FROM customers
WHERE id = ?;
次のようなSoft Deleteを検討します。
UPDATE customers
SET deleted_at = NOW()
WHERE id = ?
  AND deleted_at IS NULL;
誤削除しても復元できます。さらに、delete_customerはSoft Delete、purge_customerだけを完全削除として分離できます。purge_customerは管理者専用にして、より強い確認を要求します。AIエージェントが通常利用するToolから不可逆なHard Deleteを外せるなら、それだけでも事故時の被害を大きく減らせます。
deleteとrestoreを対にする
Soft Deleteを使うなら、delete_customer・restore_customerをセットにできます。削除結果として、次のようなものを返せば、モデルやClientも復元可能な操作であることを理解できます。
{
  "customerId": "123",
  "deleted": true,
  "recoverableUntil": "2026-10-10T10:00:00Z"
}
即時Hard Deleteより、Undo可能なOperationを優先するのが安全です。
idempotentHintは実装が本当に冪等な場合だけtrueにする
Tool AnnotationにはidempotentHintがあります。同じArgumentsで複数回呼んでも追加の副作用が発生しない場合にtrueとします。現行MCP SDKではDefaultはfalseです。
たとえばset_customer_status(id="123", status="disabled")が、disabled→disabledとなるだけなら冪等に設計しやすいでしょう。一方、increment_credit(id="123", amount=100)は2回呼ぶと200増えるため、冪等ではありません。AnnotationだけidempotentHint=trueにしても、実装は冪等になりません。
削除Toolも冪等に設計できる
たとえばSoft Deleteなら、次のように、すでに削除済みなら追加変更しない設計ができます。
UPDATE customers
SET deleted_at = COALESCE(
    deleted_at,
    NOW()
)
WHERE id = ?;
Tool Resultも次のように正常終了させられます。
{
  "customerId": "123",
  "status": "already_deleted"
}
このような実装なら、Network Retryなどで同じTool Callが再送されても被害が広がりにくくなります。ただし対象が一度削除された後に同じIDで再生成されるシステムなどでは、単純なIDだけで本当に冪等と言えるか慎重に確認する必要があります。
PaymentやEmail送信にはIdempotency Keyを使う
削除よりさらに注意したいのが、決済・メール送信・注文作成・チケット発行などです。同じTool Callが2回実行されると、二重課金・二重送信・二重注文になる可能性があります。
この場合、idempotency_keyをTool Argumentとして持たせる方法があります。
@mcp.tool()
def create_order(
    customer_id: str,
    product_id: str,
    idempotency_key: str,
):
    ...
Server側で、同じIdempotency Keyならすでに処理済みとして以前の結果を返します。ただしKeyをAIに適当に毎回生成させるだけでは、Retry時に別Keyになる可能性があります。Client Request IDやServerが発行したOperation IDなど、同じ論理操作で再利用できる値と関連付けるほうが安全です。
「delete_all」のような広すぎるToolを避ける
次のToolは特に危険です。
@mcp.tool()
def delete_customers(
    filter: dict
):
    ...
モデルがFilterを誤れば、大量削除になります。可能なら、対象IDを明示・最大件数を制限・Previewを必須にします。
大量操作が本当に必要なら、preview_bulk_deleteで次のように件数をユーザーへ見せてから実行します。
{
  "matched": 1832,
  "sampleIds": [
    "101",
    "102",
    "103"
  ]
}
たとえば「100件以上なら追加確認必須」といったServer-side Ruleを入れる方法もあります。
自然言語だけで対象を指定させない
次のようなToolも危険です。
delete_customer(
    customer="先月登録した古いテストユーザー"
)
「古い」「不要」「テストユーザー」などの解釈をモデルに任せることになります。削除実行時にはcustomer_idなど一意なIdentifierを要求します。自然言語検索は別Toolで行います。
search_customers
  ↓
候補IDを取得
  ↓
get_customer
  ↓
対象を確認
  ↓
delete_customer(customer_id)
という段階を踏むほうが安全です。
Prompt Injectionを前提にServer側で権限確認する
AIが外部WebページやIssue、メールなどを読み取る場合、「このデータを削除してください」という悪意ある指示が含まれている可能性があります。モデルがそれを正当な命令と誤認しても、Server側のAuthorizationが正しければ被害を限定できます。
たとえばcustomers:read・customers:write・customers:deleteのように権限を分けます。通常のAgentにはcustomers:read・customers:writeまでしか与えず、customers:deleteは必要なUserやClientだけに許可します。
前の記事で解説したOAuthと同様、Tool Argumentにadmin=trueと入っていることを権限確認には使いません。認証済みIdentityとServer側Permissionを確認します。
Tool Descriptionにも副作用を具体的に書く
Tool名だけでなくDescriptionも重要です。たとえば次のような簡素なDescriptionより、
@mcp.tool()
def delete_customer(
    customer_id: str
):
    """Delete customer."""
次のように副作用を明記します。
@mcp.tool()
def delete_customer(
    customer_id: str
):
    """
    Soft-delete one customer.

    This operation changes persistent data.
    It does not permanently purge the record.
    Use get_customer first to confirm the target.
    """
モデルはTool Descriptionも見てToolを選択します。ただしDescriptionは安全性を高める補助であり、Server-side Validationの代わりにはなりません。
update Toolでは変更可能FieldをAllowlistする
次のようなGeneric Update Toolは便利ですが危険です。
@mcp.tool()
def update_customer(
    customer_id: str,
    data: dict
):
    ...
モデルが{"role": "admin", "billing_status": "paid", "deleted_at": null}など、本来変更させるつもりのないFieldまで渡せる可能性があります。
代わりに、変更可能なFieldだけをInput Schemaへ公開します。
@mcp.tool()
def update_customer_profile(
    customer_id: str,
    display_name: str | None = None,
    email: str | None = None,
    expected_version: int = 0,
):
    ...
MCP Python SDKでは型HintやPydantic制約からInput Schemaを生成し、不正な型や制約違反をTool Handler実行前に拒否できます。DatabaseのColumn名をモデルへ自由入力させる必要はありません。
JSON SchemaのValidationだけではBusiness Ruleを保証できない
Input Schemaでcustomer_idはstring・amountはintegerを保証しても、そのCustomerを削除してよいか、そのOrderはCancel可能か、現在のUserがOwnerかまでは分かりません。
そのためTool Handlerでは、Schema Validationの後にBusiness Ruleを検証します。たとえば注文キャンセルなら、次のような処理にします。
存在確認
  ↓
Userがその注文へアクセス可能か確認
  ↓
現在Statusがcancellableか確認
  ↓
Version確認
  ↓
Cancellation
Database更新はTransactionでまとめる
1つのTool Callで複数のDatabase変更が必要な場合があります。たとえばCustomer削除時に、CustomerをSoft Delete・Sessionを無効化・API Tokenを失効・Audit Logを保存するとします。
途中でErrorになると、Customerだけ削除済みでAPI Tokenは有効、という中途半端な状態になる可能性があります。可能ならDatabase Transactionを利用し、すべて成功ならCommit、どれか失敗ならRollbackにします。
AIエージェントから見るとTool Callは1つの論理操作なので、Server側でもAtomicに近い単位にまとめるほうが扱いやすくなります。
外部APIを含む場合はRollbackできない前提で設計する
Database Transactionだけでは、メール送信・外部Payment API・GitHub Issue作成・Cloud Resource削除などをRollbackできません。この場合は処理順序を考えます。
たとえば、DBを削除した後に外部API失敗、より、事前Validation→外部処理→DB状態更新が適切なケースもあります。逆に外部処理が成功しDB更新が失敗する可能性もあります。そのため、Retry可能か・Idempotency Keyが使えるか・Compensating Actionがあるかを設計します。
たとえば作成したCloud Resourceを後から削除できるなら、失敗時にCompensating Actionとして削除します。
失敗時に「再実行してください」だけ返さない
Tool Errorで「処理に失敗しました。もう一度実行してください。」とだけ返すと、モデルがすぐ再実行する可能性があります。破壊的Toolでは危険です。
Server側で、操作が実行される前に失敗したのか、操作自体は成功したがResponse送信で失敗したのか区別できる設計が重要です。Idempotency KeyやOperation IDを使えば、再実行時に「このOperationはすでに成功しています」と判断できます。
結果には変更後の状態を返す
更新ToolがOKだけ返すより、次のようなStructured Resultを返すほうが安全です。
{
  "customerId": "123",
  "status": "disabled",
  "version": 19,
  "updated": true
}
モデルは何が実際に変更されたかを確認できます。削除なら次のようにします。
{
  "customerId": "123",
  "deleted": true,
  "mode": "soft-delete"
}
前の記事で解説したoutputSchemaとstructuredContentを利用すれば、Client側も変更結果を安定して処理できます。
削除後に存在確認する
重要な操作では、変更後のStateをServer側で確認する方法もあります。たとえば、UPDATE→対象を再取得→deleted_atが設定されたことを確認→成功Result、とします。
外部APIでも可能なら、DELETE Request→GET Request→削除済みを確認、とします。ただしAPIによってはEventual Consistencyがあるため、必ずしも即座に確認できるとは限りません。対象Systemの特性に合わせます。
監査ログを残す
破壊的Toolでは、後から誰が・いつ・何を・どのToolで・どの値からどの値へ変更したかを追えることが重要です。たとえばAudit Logには、次のような項目を記録できます。
request_id
user_id
client_id
tool_name
resource_id
operation
old_version
new_version
result
timestamp
削除なら、少なくとも対象IDと実行主体、結果を残します。ただしAccess TokenやPasswordなど秘密情報はLogへ保存しないようにします。
BeforeとAfterを保存すると調査しやすい
更新処理なら、次のような差分をAudit Logへ残すと、誤操作時の調査が容易になります。
{
  "before": {
    "status": "active"
  },
  "after": {
    "status": "disabled"
  }
}
ただし個人情報や巨大Dataを無条件で丸ごと保存する必要はありません。必要なFieldだけ記録します。
dry-runを用意する
一括更新やDeploymentのように影響範囲が大きい操作では、dry_runも有効です。
@mcp.tool()
def disable_inactive_users(
    days: int,
    dry_run: bool = True,
):
    ...
として、Defaultでは変更せず、次のように返します。
{
  "matched": 48,
  "modified": 0,
  "dryRun": true
}
ただし前述したconfirm=trueと同じく、単純なdry_run=Falseをモデルが設定できるだけでは人間確認の代わりにはなりません。dry-runは影響確認の機能であり、AuthorizationやConfirmationとは別です。
本番Environmentはさらに権限を分離する
同じToolでdevelopment・staging・productionを引数として自由に選べる構成も注意が必要です。たとえば{"environment": "production"}をモデルが自分で指定できます。
本番操作は、別MCP Server・別Credential・別OAuth Scope・別Toolに分ける方法もあります。たとえばdeploy_stagingは通常Agentへ許可し、deploy_productionは特定Clientだけに公開します。「Environment名を引数へ入れれば安全」という設計より、Credential Boundaryそのものを分けるほうが強力です。
削除できる件数をServer側で制限する
一括削除が必要でも、「1回最大50件」などHard Limitを設けられます。モデルが「全ユーザーを削除」と判断しても1回のTool Callで全件削除できなくなります。
大量操作は、Preview→件数表示→強いConfirmation→Batch処理のように別Workflowへ分けます。単純な1件削除と数万件削除を同じ安全レベルで扱わないことが重要です。
Tool Annotation・Confirmation・Permissionはそれぞれ役割が違う
破壊的MCP Toolでは、1つの仕組みだけで安全性を確保することは難しくなります。
destructiveHintはClientへ危険性を伝えるものです。MCP公式SDKも、AnnotationはSecurityではないと明示しています。
Elicitationや2026-07-28のMulti Round-Trip Requestは、モデルが生成した引数とは別経路でユーザー確認を取得するために利用できます。Python SDKには削除前確認のResolverが実際に用意されています。
Authorizationは、そのUserやClientがその操作を実行できるかをServer側で判断します。expected_versionは古いStateをもとにした上書きを防ぎます。IdempotencyはRetryや二重実行による副作用を抑えます。
Soft Deleteは事故が起きた後の復旧手段になります。Transactionは途中失敗による中途半端なStateを防ぎます。Audit Logは事故後に何が起きたかを追跡できるようにします。
MCPの破壊的Tool設計に関するよくある質問
QdestructiveHintをtrueにすれば、Clientは必ず確認を求めますか?
Aいいえ、保証されません。MCP Python SDKの公式ドキュメントでも、AnnotationはClient向けのHintであってSecurity機構ではないと明記されています。Clientの実装によって確認の有無は変わるため、重要な確認はServer側のElicitationなど別の経路で取得する必要があります。
QElicitationを使えば確認は常に安全になりますか?
AElicitation自体はモデルが勝手に生成できない経路でUser Inputを取得できる点で有効ですが、それだけで十分ではありません。確認後に権限確認・Version確認などのServer側検証を行い、実際の副作用は確認が完了した最終段階でのみ発生させる設計と組み合わせる必要があります。
QSoft Deleteにしておけば監査ログは不要になりますか?
A不要にはなりません。Soft Deleteはデータの復元を容易にしますが、「誰が・いつ・何を変更したか」を追跡する役割は別です。Soft Deleteと監査ログはそれぞれ目的が異なるため、両方実装するのが安全です。
QidempotentHintをtrueにしておけば実装も自動的に冪等になりますか?
Aなりません。idempotentHintはClientへ伝えるMetadataであり、実装の振る舞いを変えるものではありません。同じ引数で複数回呼んでも追加の副作用が出ないように、Tool Handler自身を冪等に実装する必要があります。
Qexpected_versionとIdempotency Keyはどちらを使うべきですか?
A目的が異なるため、場面に応じて使い分けます。expected_versionは「古い情報をもとに上書きしていないか」を防ぐ楽観的ロックで、更新系のToolに向いています。Idempotency Keyは「同じ操作が複数回実行されていないか」を防ぐもので、決済や注文作成など新規作成系のToolに向いています。両方が必要になる操作もあります。
MCPの破壊的Toolは「実行できる」より「間違って実行されても壊れにくい」を目指す
MCP Toolに削除や更新を実装すること自体が危険なのではありません。危険なのは、モデルが対象を選ぶ→Toolが即座に不可逆処理を行う、だけの構成です。
まずToolを読み取りと更新に分離し、破壊的Toolには次のようなAnnotationを付けて性質をClientへ明示します。
ToolAnnotations(
    read_only_hint=False,
    destructive_hint=True,
)
ただしAnnotationはSecurity Boundaryではありません。不可逆な操作では、ユーザー確認をTool Argumentのconfirm=trueで済ませず、Elicitationなどモデルが勝手に生成できない経路で取得します。2026-07-28ではUser Input取得がMulti Round-Trip方式になっているため、副作用は確認後の最終段階でだけ発生させることも重要です。
更新処理にはexpected_versionなどのPreconditionを持たせ、モデルが古い情報をもとに新しい変更を上書きすることを防ぎます。削除は可能ならSoft Deleteにし、完全削除はより強い権限を持つ別Toolへ分離します。二重実行が問題になる処理にはIdempotency Keyを持たせます。
そしてServer側で、Authentication・Authorization・Validation・Confirmation・Concurrency Control・Transaction・Audit Logを実装します。
MCPの破壊的Toolで重要なのは、AIモデルが常に正しい判断をすると期待することではなく、モデルが間違ったTool Callを生成した場合でもServer側で被害を止められる設計にすることです。
読み取りToolでは「便利に使えるか」が中心になりますが、削除・更新Toolでは「誤実行されても復元できるか」「二重実行されても追加被害が出ないか」「古いStateを上書きしないか」まで含めて設計すると、安全にAIエージェントへ操作権限を与えやすくなります。