Claude Codeを使っていると、必ず壁にぶつかる場面があります。新しいプロジェクトに参加したとき、チームメンバーが交代したとき、数ヶ月ぶりに長期プロジェクトに戻ったとき——前回のセッションで共有した情報が一切引き継がれていないという状況です。
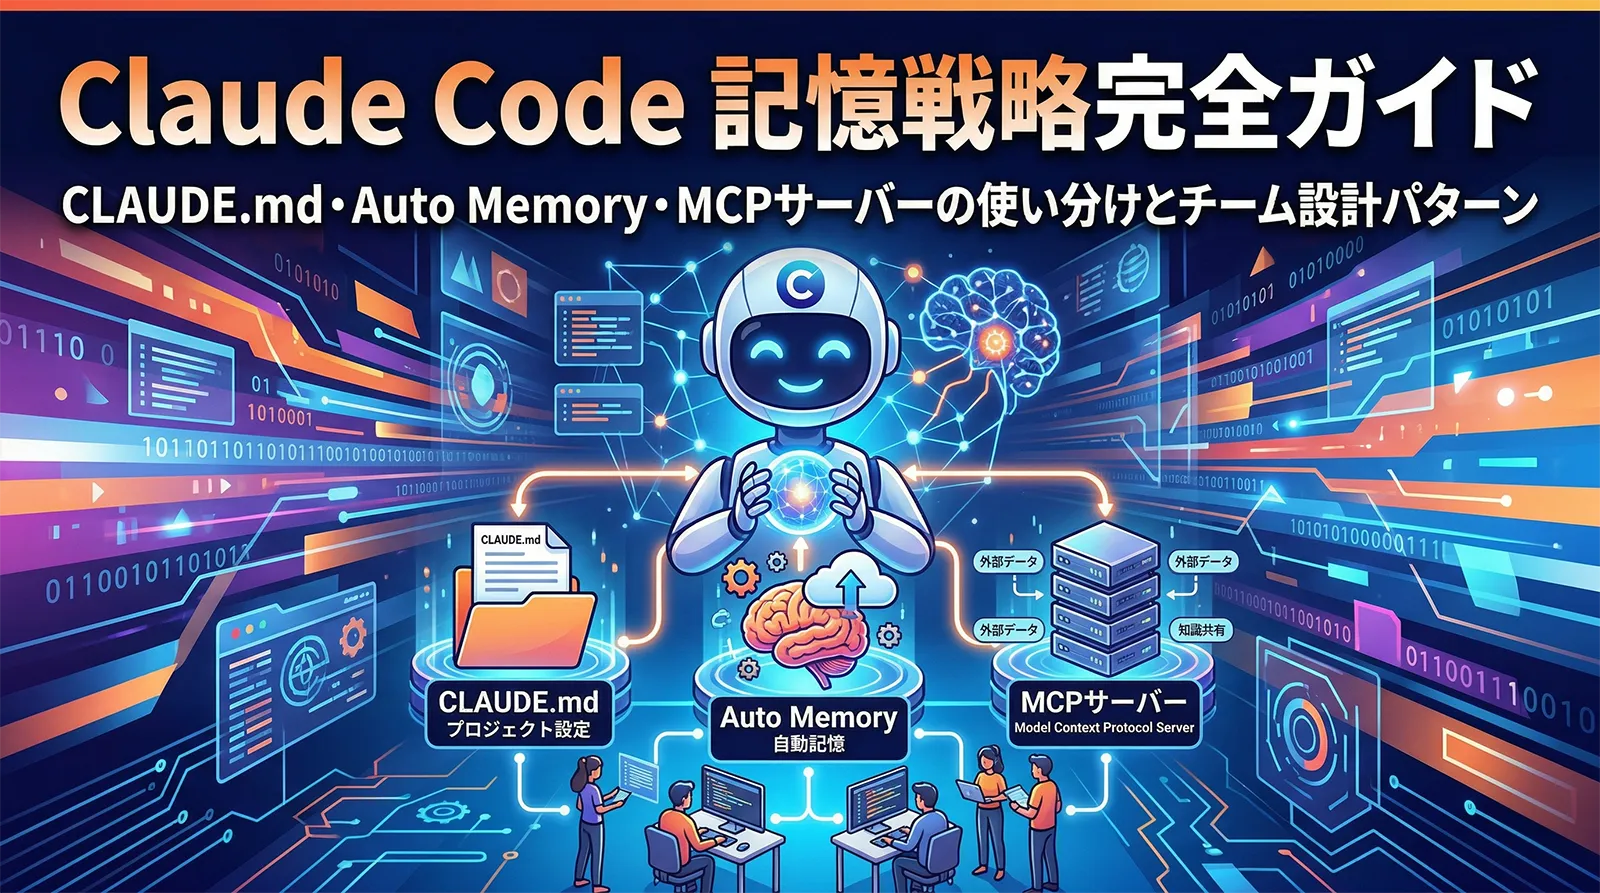
これはClaude Codeの仕様上、避けられない問題でした。しかし現在は、CLAUDE.md・Auto Memory・MCPメモリサーバーという3つの記憶メカニズムを使いこなすことで、セッションをまたいだ知識の継続が可能になっています。
この記事では「何をどこに置くか」という判断基準を中心に、チーム設計パターンやMCPメモリサーバーの選択・設定まで、記憶戦略の全体像を解説します。Claude Code全般の概要はClaude Code完全ガイドを、各機能の詳細はそれぞれの専門記事をご参照ください。
・CLAUDE.md完全ガイド——書き方・構成・@インポートの詳細
・Auto Memory完全ガイド——MEMORY.md・/memoryコマンドの詳細
・MCP完全ガイド——MCPサーバーの設定・使い方の詳細
Claude Codeの記憶3層構造
Claude Codeの記憶システムは大きく3層に分かれています。それぞれ役割・対象・更新方法が異なるため、目的に合わせて使い分けることが重要です。
| 項目 | CLAUDE.md | Auto Memory | MCP記憶サーバー |
|---|---|---|---|
| 管理方法 | 手動記述 | Claudeが自動学習 | 外部サーバー |
| 保存場所 | プロジェクト内(.claude/CLAUDE.md等) | ~/.claude/projects/.../memory/ |
ローカルDBや外部ストレージ |
| チーム共有 | Git管理で可能 | 不可(マシンローカル) | 設定次第で可能 |
| 更新タイミング | 手動 | セッション中に自動 | 会話中随時 |
| 読み込みタイミング | セッション開始時 | セッション開始時(MEMORY.md先頭200行) | Claudeが判断して参照 |
| 向いている情報 | チームルール・技術スタック・コマンド | 個人の作業知識・習慣・デバッグ知見 | 長期・横断的ナレッジ |
3層は独立していますが、互いに補完し合います。たとえば「プロジェクトのビルドコマンドはpnpm build」という情報はCLAUDE.md(全員が使う)にも書けますし、Auto Memory(自分が気づいた時点で記録)にも保存されることがあります。重複しても問題はありません。
・CLAUDE.mdの書き方・@インポート・階層化 → CLAUDE.md完全ガイド
・Auto Memoryの仕組み・/memoryコマンド・設定 → Auto Memory完全ガイド
本記事では「使い分け・チーム設計・MCPメモリ」に集中して解説します。
何をどこに置くか——判断の基準
3層のどこに情報を置くかは、次の3つの問いで決まります。
| 問い | 条件 | 置き場所 |
|---|---|---|
| チームで共有すべき情報か? | YES | CLAUDE.md(Gitにコミット) |
| 自動学習させて個人で使う情報か? | YES | Auto Memory(自動) |
| 複数プロジェクトをまたいで長期保存したい情報か? | YES | MCPメモリサーバー |
| どれにも当てはまらない | — | まずはAuto Memoryで様子を見る |
具体例で見る判断
抽象的なルールより、具体例で確認するほうが分かりやすいです。
| 情報の内容 | 置き場所 | 理由 |
|---|---|---|
| このプロジェクトはpnpmを使う | CLAUDE.md | 全メンバーが知るべきチームルール |
ビルドコマンドはnpm run build:prod |
CLAUDE.md | 全員が正確に知る必要がある |
RedisのOOMエラーはmaxmemory-policy allkeys-lruで解決した |
Auto Memory | 個人の作業から得たデバッグ知見 |
| Aさんはテストをvitest形式で書く | Auto Memory | 個人スタイルの記憶 |
| 3ヶ月前に調査した競合APIのエンドポイント一覧 | MCPメモリサーバー | 長期保存・横断検索が必要 |
| 複数プロジェクトで共通のアーキテクチャパターン | MCPメモリサーバー | プロジェクトをまたいだ知識 |
「git pushしてチーム全員に届けるべき情報か?」がYESならCLAUDE.md。それ以外の作業知識はAuto Memoryに任せる。プロジェクトをまたいで何ヶ月も参照したい情報だけMCPサーバーを検討する。
CLAUDE.md × Auto Memory の組み合わせ最適化
2つのシステムを組み合わせることで、チーム共有と個人の知識蓄積を同時にうまく管理できます。ここでは具体的な「分け方」の実践を紹介します。
@インポートでCLAUDE.mdをモジュール化する
プロジェクトが大きくなるにつれてCLAUDE.mdが肥大化しがちです。@インポート機能を使って、役割別にファイルを分割するのが効果的です。
# プロジェクトのCLAUDE.md構成(@インポートを活用)

CLAUDE.md(ルート・概要のみ)
├── @.claude/tech-stack.md       # 技術スタック・バージョン情報
├── @.claude/team-rules.md       # コーディング規約・レビュールール
├── @.claude/commands.md         # よく使うコマンド集
└── @.claude/troubleshooting.md  # 既知の問題と解決策
# プロジェクト概要
ECサイトのバックエンドAPI。Node.js + TypeScript + PostgreSQL。

## 技術スタック
@.claude/tech-stack.md

## チームルール
@.claude/team-rules.md

## コマンド集
@.claude/commands.md

## 既知の問題と対処
@.claude/troubleshooting.md
ルートのCLAUDE.mdはプロジェクト概要と@インポート宣言だけに絞ります。これによりClaudeがトークンを無駄に消費するのを防げますし、各ファイルを担当者が独立して更新できるようになります。各ファイルの具体的な書き方についてはCLAUDE.md完全ガイドに詳しい例を掲載しています。
Auto MemoryのMEMORY.mdインデックス最適化
Auto MemoryのMEMORY.mdは先頭200行しかセッション開始時に読み込まれません。ここにすべての詳細を書き込むのは逆効果です。ポインター(目次)だけを書き、詳細はトピックファイルに任せるのが正解です。
# プロジェクトメモリ

## ビルドコマンド
パッケージマネージャーはpnpm。ビルドはpnpm buildで実行する。
本番向けはpnpm build:prodを使い、環境変数NODE_ENV=productionが必要。
ステージングはpnpm build:stagingで別の設定ファイルを参照する。
テストはpnpm testで実行するが、先にDockerでRedisとPostgreSQLを起動しておく必要がある。
Redisのポートは6379、PostgreSQLは5432で固定。
型チェックはpnpm typecheckで実行し、エラーが0になるまでPRを出してはいけない。
ローカルDB接続情報はdotenv経由で.env.localから読み込む...(以下延々と続く)
# プロジェクトメモリ(インデックス)

## 環境・コマンド
詳細 → [build-commands.md](build-commands.md)(ビルド・テスト・デプロイ手順)

## アーキテクチャ
詳細 → [architecture.md](architecture.md)(ディレクトリ構成・モジュール依存関係)

## デバッグ知見
詳細 → [debugging.md](debugging.md)(遭遇したエラーと解決策の蓄積)

## 外部サービス
詳細 → [services.md](services.md)(API・Webhook・外部連携の設定メモ)
ポインター設計にすることで、MEMORY.mdは常に短く保てます。Claudeは作業内容に応じて必要なトピックファイルを自分で判断して読み込みます。
チーム開発でのCLAUDE.md設計
.gitignoreとの関係
CLAUDE.mdはチームで共有するためGitにコミットします。Auto MemoryはデフォルトでホームディレクトリのGit外に保存されるため、通常は意識しなくてよいです。ただしプロジェクト内にメモリディレクトリを設ける場合は除外が必要です。
# CLAUDE.mdはコミット必須
# (除外しない)

# Auto Memoryはデフォルトで ~/.claude/ 以下に保存されるためGit除外不要
# プロジェクト内にメモリフォルダを置く場合のみ除外
.claude/projects/
memory/

# チームで共有しない個人設定
.claude/settings.local.json
チーム規模別・CLAUDE.md設計パターン
チームの規模や開発スタイルに合わせて、CLAUDE.mdの設計を変えるのが効果的です。3つのパターンを紹介します。
最小構成(1〜3人・短期プロジェクト)
1ファイル・50行以内でシンプルに管理します。@インポートは不要です。
# プロジェクト概要
Next.js + TypeScript + Prisma の個人ブログ。

## 技術スタック
- Node.js: 20.x
- パッケージマネージャー: pnpm
- DB: SQLite(ローカル)/ PostgreSQL(本番)

## コマンド
- 開発: `pnpm dev`
- ビルド: `pnpm build`
- DBマイグレーション: `npx prisma migrate dev`
- テスト: `pnpm test`

## 注意事項
- 本番DBへの直接接続は禁止。Prismaを必ず経由すること
- APIルートにはZodバリデーションを必ず追加する
標準構成(5〜10人)
@インポートでファイルを分割し、担当領域ごとに独立して更新できるようにします。
# プロジェクト概要
マルチテナントSaaSプラットフォーム。React + Node.js + PostgreSQL。

## 重要ルール(全員必読)
@.claude/critical-rules.md

## 技術スタック
@.claude/tech-stack.md

## 開発コマンド
@.claude/commands.md

## コードレビュー基準
@.claude/review-guide.md
セキュリティ禁止事項・デプロイ手順・テストカバレッジ基準など、「チーム全員が絶対に守るべきルール」を箇条書きで記載します。ファイルの書き方の詳細サンプルはCLAUDE.md完全ガイドをご覧ください。
大規模構成(10人以上・モノレポ)
サブディレクトリごとにCLAUDE.mdを配置し、担当領域のルールをローカルに持ちます。ルートのCLAUDE.mdは全体共通ルールのみに絞ります。
# モノレポの場合のCLAUDE.md配置

プロジェクトルート/
├── CLAUDE.md                    # 全体共通ルール(認証・デプロイ・セキュリティ)
├── apps/
│   ├── frontend/
│   │   └── CLAUDE.md            # フロントエンド固有ルール(React・デザイン)
│   └── backend/
│       └── CLAUDE.md            # バックエンド固有ルール(API設計・DB)
├── packages/
│   └── shared/
│       └── CLAUDE.md            # 共有ライブラリのルール(破壊的変更手順等)
└── .claude/
    ├── team-rules.md            # @インポート用共通ファイル
    └── commands.md              # 全体コマンド集
ルートのCLAUDE.mdは全体共通ルールと@インポート宣言のみに絞り、各サブプロジェクトのCLAUDE.mdへの参照を記載します。このパターンの詳細な実装例については大規模コードベースガイドも参照してください。
MCPメモリサーバーが必要なケース
CLAUDE.mdとAuto Memoryの組み合わせで多くの場合はカバーできます。しかし次のような場面では、MCPメモリサーバーの導入を検討する価値があります。
- 複数マシン・複数メンバーで同じ調査結果やナレッジを共有したい
- 数ヶ月前に調査した情報を横断的に全文検索したい
- 複数のプロジェクトをまたいで共通の知識ベースを構築したい
- Auto Memoryはプロジェクト単位なので、横断的な活用が難しい
MCPの基本概念についてはClaude Code MCPガイドをご参照ください。以下ではメモリ用途に特化したMCPサーバーの選択肢を紹介します。
MCPメモリサーバーの選択肢
| ツール | 形式 | 検索方式 | 向いている用途 |
|---|---|---|---|
| Claude Memory MCP | npx(Node.js) | SQLite FTS5(全文検索) | シンプルな汎用メモリ・セッション横断の調査記録 |
| Serena | uvx(Python) | セマンティック+ファイルシステム | コードインテリジェンス+プロジェクト記憶の併用 |
Claude Memory MCPの設定例
Claude Memory MCPはSQLite FTS5を使ったシンプルなメモリサーバーです。調査結果や判断の記録を自然言語で保存・検索できます。
{
  "mcpServers": {
    "memory": {
      "command": "npx",
      "args": ["-y", "github:whenmoon-afk/claude-memory-mcp"]
    }
  }
}
設定後、Claudeとの会話の中で次のように使えます。
# 記憶の保存(Claude への指示)
「この調査結果をメモリに保存して: SendGridのRate LimitはIPあたり100req/sec」

# 記憶の検索(Claude への指示)
「SendGridのRate Limitに関するメモリを検索して」

# セッションを超えた参照
→ 次のセッションでも「SendGridのRate Limitについて教えて」と聞けば参照できる

# メモリDBの場所
~/.memory-mcp/memory.db(SQLiteファイル)
Serenaの設定例
SerenaはコードのシンボルをLSP的に解析する機能がメインですが、.serena/memories/ディレクトリにプロジェクト記憶も保存できます。コードベース解析と記憶管理を同時に行いたい場合に向いています。
claude mcp add-json "serena" '{"command":"uvx","args":["--from","git+https://github.com/oraios/serena","serena-mcp-server","--project-from-cwd"]}'
Serenaを追加すると、Claude Codeはコードのシンボル検索・定義参照・リファクタリング補助に加えて、プロジェクト固有の記憶も保持できるようになります。大規模コードベースでの活用は大規模コードベースガイドも参考にしてください。
この記事で紹介したMCPメモリサーバーはAnthropicが公式に提供するものではなく、コミュニティ製のサードパーティツールです。バージョンアップデートによって動作が変わる場合があるため、導入前に必ずGitHubリポジトリの最新READMEで動作要件・インストール手順を確認してください。
プロジェクト規模別・記憶設計の推奨パターン
プロジェクトの規模・期間・メンバー数によって最適な記憶設計は異なります。4つのパターンで整理します。
パターン1: 個人プロジェクト(1人・短期)
- CLAUDE.md: 必要最小限(20行以内)。コマンドと注意点だけ書く
- Auto Memory: そのまま使う。設定不要
- MCP: 不要
# プロジェクト概要
Next.js + TypeScript + Prismaの個人ブログ

## コマンド
- 開発: `npm run dev`
- DB: `npx prisma migrate dev`
- テスト: `npm test`

## 注意
- `.env.local`はgit管理外(APIキーが含まれるため)
パターン2: スモールチーム(2〜5人)
- CLAUDE.md: @インポートで3〜4ファイルに分割。役割別に管理
- Auto Memory: 個人マシンの作業ログとして機能させる
- MCP: 調査内容が多い場合のみ検討(なくても十分なことが多い)
新メンバーが参加したとき、CLAUDE.mdをGit cloneするだけでチームルールと開発コマンドが即座にClaude Codeに読み込まれます。オンボーディングコストを大幅に削減できます。
パターン3: ミドルチーム(6〜15人)
- CLAUDE.md: サブディレクトリ別に配置(frontend/CLAUDE.md, backend/CLAUDE.md)
- Auto Memory: 担当領域ごとに個人の知識が蓄積される
- MCP: Claude Memory MCPで共有ナレッジベースの構築を検討
このサイズのチームでは「チーム全員で共有したい調査結果や設計メモ」が蓄積されてきます。Auto Memoryでは個人ローカルにしか保存できないため、Claude Memory MCPを導入して共有ナレッジベースを構築するのが効果的です。
パターン4: 長期・大規模プロジェクト(16人以上・長期)
- CLAUDE.md: 階層化・モノレポ対応。サブプロジェクト別に独立管理
- Auto Memory: 各担当者の専門領域で自動最適化
- MCP: Serena(コード解析記憶)+ Claude Memory MCP(調査記憶)の併用も選択肢
大規模プロジェクトでは、CLAUDE.mdの更新プロセス自体をチームのワークフローに組み込むことが重要です。新しい技術決定や重要なデバッグ解決があった場合、CLAUDE.mdの該当セクションをPRと合わせて更新するルールを設けるとよいでしょう。大規模コードベース特有の課題については大規模コードベースガイドを参照してください。
チームメンバーの交代・引き継ぎへの対応
メンバー交代時の引き継ぎは、記憶設計が整っているかどうかで大きく変わります。3層ごとに引き継ぎの考え方を整理します。
| 記憶層 | 引き継ぎ方法 | 手間 |
|---|---|---|
| CLAUDE.md | GitにコミットされているためClone後すぐに使える。追加作業不要 | なし |
| Auto Memory | マシンローカルのため引き継ぎ不要。新メンバーはゼロから学習——Claudeが作業を通じて自動記憶 | なし(自動) |
| MCPメモリサーバー | 共有設定(共有DB等)なら自動引き継ぎ。個人設定の場合はエクスポート・共有が必要 | 設定次第 |
CLAUDE.mdをしっかり整備していれば、新メンバーはCloneした時点で「このプロジェクトのルール・コマンド・禁止事項」がClaude Codeに読み込まれた状態で作業を始められます。これがCLAUDE.mdをGit管理する最大のメリットです。
CLAUDE.mdは人間も読めるMarkdownです。”Claude Code向けの指示”としてだけでなく、”新メンバー向けのプロジェクト概要書”としても機能します。README.mdとは別に、CLAUDE.mdにプロジェクト固有の注意点・コマンド・アーキテクチャ概要を書いておくと、Claude Code利用者でない新メンバーにとっても参照しやすいドキュメントになります。
よくある落とし穴と対処法
CLAUDE.mdに実装詳細を書きすぎてしまう
CLAUDE.mdはセッション開始時にすべてのトークンを消費して読み込まれます。数千行のCLAUDE.mdはClaudeのコンテキスト上限を圧迫し、実際の作業に使えるトークンが減ってしまいます。
解決策は2つです。
- @インポートで詳細を別ファイルに分割し、ルートCLAUDE.mdは概要のみにする
- 最重要ルールを先頭に置き、後続は参照的な内容にする(先頭が最も重要)
Auto Memoryに機密情報が入ってしまう可能性
Claudeはパスワードやシークレットキーを意図的には記憶しませんが、会話の中でAPIキーを伝えた場合など、誤ってメモリに含まれる可能性がゼロではありません。
定期的に/memoryコマンドでメモリファイルを確認し、機密情報が含まれていないかチェックする習慣をつけましょう。メモリファイルはテキストファイルなので直接編集して削除できます。
MCPメモリサーバーを早期に導入しすぎる
MCPメモリサーバーは設定・保守コストがかかります。CLAUDE.md + Auto Memoryの組み合わせで解決できないと確認してから導入を検討してください。多くの個人プロジェクトや小規模チームでは2層で十分です。
どれだけ高度な記憶システムを設計しても、チームが更新・確認しなければ形骸化します。まずCLAUDE.mdとAuto Memoryで運用を確立し、それでは足りないと感じたときにMCPを追加するのが現実的です。
実践的な記憶設計ワークフロー
実際の開発プロジェクトで記憶設計を整備する際は、いきなり完璧な構成を目指すより、段階的に構築していく方がうまくいきます。以下に推奨するワークフローを示します。
フェーズ1: プロジェクト立ち上げ時(初日)
最初の日にやることは1つだけです。CLAUDE.mdを作ることです。完璧でなくて構いません。最低限の情報を書いてGitにコミットします。
# [プロジェクト名]

## 概要
[1〜2行でプロジェクトの目的]

## 技術スタック
- 言語: [例: TypeScript 5.x]
- フレームワーク: [例: Next.js 14]
- DB: [例: PostgreSQL + Prisma]
- パッケージマネージャー: [例: pnpm]

## 開発コマンド
- 起動: `[コマンド]`
- テスト: `[コマンド]`
- ビルド: `[コマンド]`

## 重要事項
- [最初から決まっているルール・制約を箇条書きで]
これだけで、Claude Codeとの作業が初回から噛み合い始めます。Auto Memoryは自動で蓄積を開始するため、初日は何も設定不要です。
フェーズ2: 開発進行中(1週間〜1ヶ月)
開発を進める中で「Claudeに毎回同じことを説明している」と気づいたら、それはCLAUDE.mdに追加すべきサインです。
- 「このプロジェクトでは○○パターンを使う」→ CLAUDE.mdの設計セクションに追加
- 「DBマイグレーションの前に必ず○○をする」→ CLAUDE.mdのコマンドセクションに注記
- 「APIのレスポンス形式は必ず○○型にする」→ CLAUDE.mdのコーディングルールに追加
Auto Memoryはこの期間に急速に成長します。Claudeがバグの解決策・コマンドのオプション・API仕様の詳細を自動的に記録していきます。定期的に/memoryで確認し、古くなった情報を削除する習慣をつけましょう。
フェーズ3: チームの拡大・長期化
チームが5人を超えてきたり、プロジェクトが6ヶ月以上続くようになったとき、CLAUDE.mdのモジュール化を検討するタイミングです。
- CLAUDE.mdが100行を超えてきたら@インポートで分割を検討
- 「この情報はフロントエンドチームだけに関係する」と思い始めたらサブディレクトリCLAUDE.mdを追加
- 「先月の技術調査をまた一から説明しなければならない」と感じたらMCPメモリサーバーを検討
CLAUDE.mdのレビュー・更新タイミング
CLAUDE.mdは一度書いたら終わりではありません。定期的な見直しが必要です。以下のタイミングで更新することを習慣にすると、常に最新の状態を保てます。
| タイミング | 確認・更新内容 |
|---|---|
| スプリント/イテレーション終了時 | チームルールの変更・新しい禁止事項の追加 |
| ライブラリのメジャーアップデート時 | 技術スタックのバージョン情報・新しいコマンド |
| 新メンバー参加前 | オンボーディングに必要な情報が揃っているか確認 |
| 重大なバグ解決後 | 同じバグを再発させないための注意事項を追加 |
| 四半期ごと | 不要になった情報の削除・全体の整理 |
新機能の実装やアーキテクチャ変更を行うとき、関連するCLAUDE.mdの更新も同じPRに含めるルールを設けると、CLAUDE.mdが自然と最新状態を保てます。コードレビューの際に「CLAUDE.mdの更新が必要か?」を確認項目に加えるだけで実現できます。
よくある質問
QCLAUDE.mdが長くなりすぎたらどうすればいいですか?
A@インポートでモジュール化してください。ルートCLAUDE.mdはプロジェクト概要と@インポート宣言のみにし、詳細は別ファイルに分けます。Claudeはセッション開始時にすべてのCLAUDE.mdを読み込むため、ファイルを分割してもトークン節約にはなりませんが、保守性が大幅に向上します。ルートCLAUDE.mdを短くすることで「最重要情報が先頭にある」状態を維持できます。
QAuto Memoryの内容を確認・編集するにはどうすればいいですか?
Aセッション内で/memoryコマンドを実行するとメモリフォルダへのリンクが表示されます。または~/.claude/projects/以下のディレクトリをファイルマネージャーで直接開いて編集できます。詳細な操作方法はAuto Memoryガイドを参照してください。
Qチームメンバーが変わったときにどう引き継ぎますか?
ACLAUDE.mdはGit管理されているため、Clone後すぐに新メンバーの環境でも有効になります。Auto Memoryは個人のマシンローカルなため引き継ぎ不要で、新メンバーの作業を通じて自動的に蓄積されます。MCPメモリサーバーを共有設定で使っている場合は接続情報を渡すだけで引き継ぎ完了です。
QMCPメモリサーバーとAuto Memoryの違いを教えてください。
AAuto Memoryはプロジェクト単位・マシンローカルで、Claudeが自動で管理します。MCPメモリサーバーは追加設定が必要ですが、複数プロジェクト横断・設定次第でチーム共有が可能です。「このプロジェクトでの自分の作業知識」はAuto Memory、「チームや複数プロジェクトで活用したい長期ナレッジ」はMCPサーバーと使い分けます。
QCLAUDE.mdとREADME.mdを分ける必要はありますか?
A分けることを推奨します。README.mdはプロジェクト全体の説明(インストール・使い方・ライセンス)が主目的で、人間が読むことを前提にした構成です。CLAUDE.mdはClaude Codeへの指示(コーディングルール・禁止事項・コマンド集)に特化します。両者は内容が重複することもありますが、それぞれ最適化された形式で書いたほうが効果的です。
Q本番環境の機密情報(DBパスワード等)はCLAUDE.mdに書いてよいですか?
A絶対に書かないでください。CLAUDE.mdはGitにコミットするファイルです。機密情報は必ず環境変数(.envファイル・CI/CDシークレット)で管理し、CLAUDE.mdには「接続情報は.env.localを参照」と記載するにとどめます。.envファイルは.gitignoreで確実に除外してください。
QAuto MemoryはCLAUDE.mdの内容を上書きしたり干渉しますか?
Aしません。CLAUDE.mdとAuto Memoryは完全に独立しています。CLAUDE.mdはGitにコミットされた静的なファイルで、Claude Codeが読み込むだけです。Auto Memoryはセッションを通じてClaudeが書き込むメモファイルです。両者がセッション開始時に読み込まれ、Claudeのコンテキストに追加されますが、互いの内容を変更・上書きする機能はありません。
QCLAUDE.mdは複数ファイルを置けますか?配置場所のルールは?
Aはい、複数のCLAUDE.mdを配置できます。Claude Codeはプロジェクトのルートから作業ディレクトリまでのすべての階層のCLAUDE.mdを読み込みます。たとえば~/プロジェクト/CLAUDE.mdと~/プロジェクト/apps/frontend/CLAUDE.mdを同時に配置すると、frontendディレクトリで作業する際は両方が読み込まれます。ホームディレクトリの~/.claude/CLAUDE.mdはすべてのプロジェクトで共通で読まれるグローバル設定として機能します。
Q記憶システムを導入してもClaude Codeの動作が変わらない気がします。
A最もよくある原因は「CLAUDE.mdに書いた内容がClaudeに届いていない」ケースです。セッション内で/memoryコマンドを実行すると、現在読み込まれているCLAUDE.mdとメモリファイルの一覧が表示されます。CLAUDE.mdが一覧に表示されていない場合は、配置場所やファイル名を確認してください。また、Claude Codeはセッション開始時にファイルを読み込むため、CLAUDE.mdを編集した後は新しいセッションを開始する必要があります。
まとめ
Claude Codeの記憶戦略は3層で構成されています。それぞれの役割を正しく理解して使い分けることが、効率的な開発の鍵です。
| 記憶層 | 何を置くか | 管理方法 |
|---|---|---|
| CLAUDE.md | チームルール・技術スタック・コマンド集・禁止事項 | Gitにコミットして全員で共有 |
| Auto Memory | 個人の作業知識・デバッグ知見・プロジェクト学習 | Claudeが自動管理(設定不要) |
| MCPメモリサーバー | 長期・横断的ナレッジ・チーム共有調査結果 | 追加設定(必要と感じたときだけ) |
導入の順番としては、まずCLAUDE.mdでチームルールを整備し、Auto Memoryが自動で個人知識を蓄積する流れを確立します。それで足りなくなったと感じたとき——複数プロジェクト横断の検索やチーム全員での調査共有が必要になったとき——に初めてMCPメモリサーバーを検討してください。
最終的に大切なのは「どれだけ洗練されたシステムを設計したか」ではなく、「チームが実際に使い続けられるか」です。CLAUDE.mdが陳腐化したまま放置されていれば、記憶システムは機能しません。更新のハードルを下げるために、まずシンプルに始めることを強く推奨します。
記憶戦略を正しく設計することで、Claude Codeは単なる「コード補助ツール」から「プロジェクトの文脈を理解した開発パートナー」へと進化します。セッションをまたいで知識が蓄積され、新メンバーが即戦力になり、過去の調査結果が無駄にならない開発環境——それが記憶戦略の目指すゴールです。
今すぐできることは、プロジェクトルートに
CLAUDE.mdを1枚作ることです。20行からでも十分です。コマンド集と最重要ルールだけ書いてGitにコミットする。これだけでClaude Codeの生産性は目に見えて上がります。書き方の詳細はCLAUDE.md完全ガイドを参考にしてください。