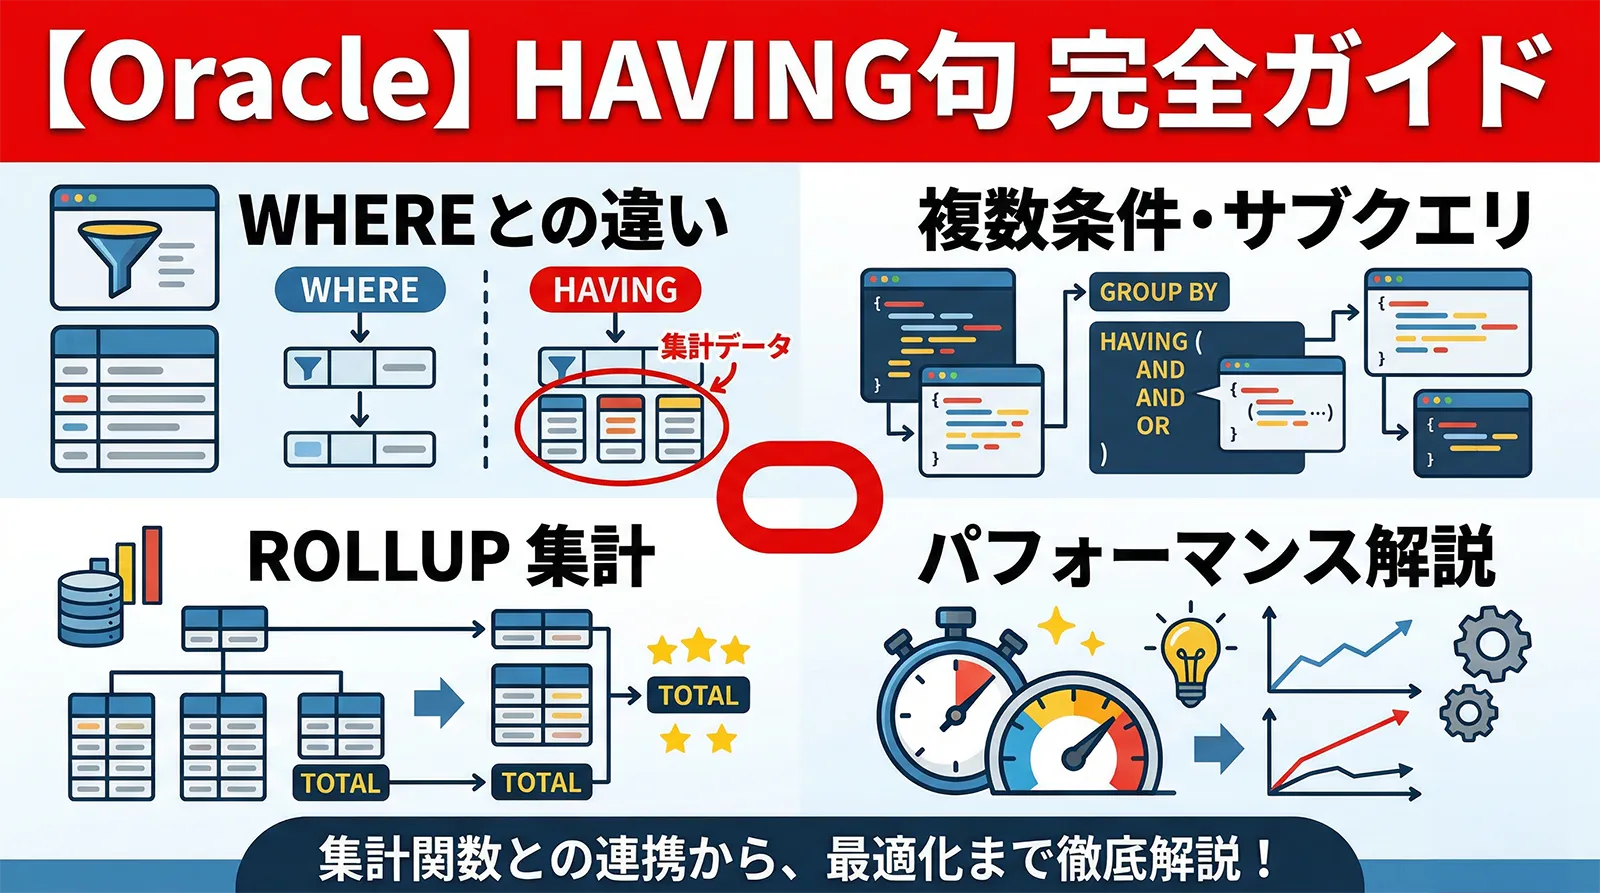
Oracle の HAVING 句は、GROUP BY でグループ化したデータに対して集計結果を条件にフィルタリングするための構文です。「部門ごとの平均給与が 5000 以上の部門だけ表示したい」「注文件数が 10 件以上の顧客を抽出したい」といった要求を実現します。
しかし「WHERE と HAVING はどう違うのか」「HAVING だけで WHERE なしでも使えるのか」「サブクエリを HAVING の条件に使えるのか」といった疑問は多いものです。
本記事では、HAVING 句の基本から、SQL 評価順序での位置づけ、WHERE との違いとパフォーマンスへの影響、複数条件・サブクエリ・ROLLUP との組み合わせまで体系的に解説します。
この記事でわかること
・HAVING 句の基本構文と動作
・SQL 評価順序における HAVING の位置づけ
・WHERE と HAVING の違い(行フィルタ vs グループフィルタ)
・HAVING での複数条件(AND / OR)
・GROUP BY なしの HAVING(テーブル全体を 1 グループとして扱う)
・HAVING + サブクエリの使い方
・HAVING + ROLLUP / CUBE で小計行をフィルタする方法
・HAVING + CASE 式で条件付き集計をフィルタする方法
・WHERE と HAVING の使い分けによるパフォーマンス最適化
・HAVING 句の基本構文と動作
・SQL 評価順序における HAVING の位置づけ
・WHERE と HAVING の違い(行フィルタ vs グループフィルタ)
・HAVING での複数条件(AND / OR)
・GROUP BY なしの HAVING(テーブル全体を 1 グループとして扱う)
・HAVING + サブクエリの使い方
・HAVING + ROLLUP / CUBE で小計行をフィルタする方法
・HAVING + CASE 式で条件付き集計をフィルタする方法
・WHERE と HAVING の使い分けによるパフォーマンス最適化
HAVING 句の基本構文
SQL(HAVING 基本)
-- 構文
SELECT column, aggregate_function(column)
FROM table_name
[WHERE row_condition]         -- 行レベルのフィルタ
GROUP BY column
HAVING aggregate_condition    -- グループレベルのフィルタ
[ORDER BY ...];

-- 例: 部門ごとの平均給与が 5000 以上の部門を抽出
SELECT department_id, AVG(salary) AS avg_salary
FROM employees
GROUP BY department_id
HAVING AVG(salary) >= 5000
ORDER BY avg_salary DESC;
SQL(各集計関数での HAVING 例)
-- COUNT: 社員数が 5 名以上の部門
SELECT department_id, COUNT(*) AS emp_count
FROM employees
GROUP BY department_id
HAVING COUNT(*) >= 5;

-- SUM: 売上合計が 100 万以上の顧客
SELECT customer_id, SUM(amount) AS total_amount
FROM orders
GROUP BY customer_id
HAVING SUM(amount) >= 1000000;

-- MAX: 最高給与が 10000 を超える部門
SELECT department_id, MAX(salary) AS max_salary
FROM employees
GROUP BY department_id
HAVING MAX(salary) > 10000;

-- MIN: 最低給与が 3000 未満の部門
SELECT department_id, MIN(salary) AS min_salary
FROM employees
GROUP BY department_id
HAVING MIN(salary) < 3000;
SQL 評価順序と HAVING の位置づけ
HAVING を正しく使うには、Oracle が SQL をどの順番で処理するかを理解することが重要です。
| 処理順 | 句 | 役割 |
|---|---|---|
| 1 | FROM / JOIN | テーブルを特定し結合する |
| 2 | WHERE | 行レベルのフィルタ(集計前に実行) |
| 3 | GROUP BY | 行をグループ化する |
| 4 | HAVING | グループレベルのフィルタ(集計後に実行) |
| 5 | SELECT | 出力列を決定する |
| 6 | ORDER BY | 結果を並べ替える |
HAVING は GROUP BY の後に評価される
WHERE はグループ化の前に行を絞り込み、HAVING はグループ化の後に集計結果を絞り込みます。この評価順序の違いが WHERE と HAVING の最大の違いであり、パフォーマンスにも直接影響します。
WHERE はグループ化の前に行を絞り込み、HAVING はグループ化の後に集計結果を絞り込みます。この評価順序の違いが WHERE と HAVING の最大の違いであり、パフォーマンスにも直接影響します。
WHERE と HAVING の違い
| 項目 | WHERE | HAVING |
|---|---|---|
| フィルタ対象 | 個々の行 | グループ(集計結果) |
| 評価タイミング | GROUP BY の前 | GROUP BY の後 |
| 集計関数の使用 | 不可(SUM, COUNT 等は使えない) | 可能(集計関数を条件にできる) |
| GROUP BY との関係 | GROUP BY なしでも使える | 通常 GROUP BY と一緒に使う |
| パフォーマンス | データを早期に絞り込むため高速 | 集計後のフィルタなので WHERE より遅い場合がある |
SQL(WHERE と HAVING の使い分け)
-- NG: WHERE に集計関数を書くとエラー
-- SELECT department_id, COUNT(*)
-- FROM employees
-- WHERE COUNT(*) >= 5   -- ORA-00934: group function is not allowed here
-- GROUP BY department_id;

-- OK: 集計結果の条件は HAVING に書く
SELECT department_id, COUNT(*) AS emp_count
FROM employees
GROUP BY department_id
HAVING COUNT(*) >= 5;

-- WHERE + HAVING を併用(推奨パターン)
-- WHERE で先に行を絞り、HAVING で集計結果を絞る
SELECT department_id, AVG(salary) AS avg_salary
FROM employees
WHERE status = 'ACTIVE'           -- 先にアクティブ社員だけに絞る
GROUP BY department_id
HAVING AVG(salary) >= 5000        -- その中で平均給与 5000 以上の部門
ORDER BY avg_salary DESC;
WHERE で書ける条件を HAVING に書かない
HAVING department_id = 10 は文法的には正しいですが、WHERE department_id = 10 と書くべきです。WHERE で先にフィルタすれば GROUP BY の処理対象が減り、パフォーマンスが向上します。HAVING には集計関数を使う条件だけを書くのがベストプラクティスです。HAVING での複数条件(AND / OR)
SQL(複数条件の HAVING)
-- AND: 両方の条件を満たすグループ
SELECT department_id,
       COUNT(*) AS emp_count,
       AVG(salary) AS avg_salary
FROM employees
GROUP BY department_id
HAVING COUNT(*) >= 5
   AND AVG(salary) >= 5000;

-- OR: いずれかの条件を満たすグループ
SELECT department_id,
       COUNT(*) AS emp_count,
       SUM(salary) AS total_salary
FROM employees
GROUP BY department_id
HAVING COUNT(*) >= 10
    OR SUM(salary) >= 500000;

-- AND + OR の組み合わせ(括弧で優先順位を明示)
SELECT department_id, COUNT(*), AVG(salary)
FROM employees
GROUP BY department_id
HAVING (COUNT(*) >= 5 AND AVG(salary) >= 5000)
    OR COUNT(*) >= 20;
GROUP BY なしの HAVING
GROUP BY を省略して HAVING だけ書くと、テーブル全体を1 つのグループとして扱います。条件を満たせば 1 行の結果が返り、満たさなければ 0 行になります。
SQL(GROUP BY なしの HAVING)
-- テーブル全体の合計が 100 万以上なら結果を返す
SELECT SUM(amount) AS total_amount
FROM orders
HAVING SUM(amount) >= 1000000;
-- 条件を満たさなければ 0 行が返る

-- テーブル全体のレコード数が 1000 以上か確認
SELECT COUNT(*) AS total_count
FROM employees
HAVING COUNT(*) >= 1000;
GROUP BY なし HAVING の用途
「テーブル全体の集計値が条件を満たすかどうか」を判定するのに使えます。条件を満たせば 1 行、満たさなければ 0 行が返るため、PL/SQL で
「テーブル全体の集計値が条件を満たすかどうか」を判定するのに使えます。条件を満たせば 1 行、満たさなければ 0 行が返るため、PL/SQL で
IF SQL%ROWCOUNT = 0 THEN ... と組み合わせた判定処理に便利です。HAVING + サブクエリ
SQL(HAVING にサブクエリを使う)
-- 全社平均より高い平均給与の部門を抽出
SELECT department_id, AVG(salary) AS avg_salary
FROM employees
GROUP BY department_id
HAVING AVG(salary) > (
    SELECT AVG(salary) FROM employees   -- 全社平均
);

-- 最も社員数が多い部門と同じ人数以上の部門を抽出
SELECT department_id, COUNT(*) AS emp_count
FROM employees
GROUP BY department_id
HAVING COUNT(*) >= (
    SELECT MAX(cnt) FROM (
        SELECT COUNT(*) AS cnt FROM employees GROUP BY department_id
    )
);
HAVING + ROLLUP / CUBE
ROLLUP や CUBE で小計行・合計行が生成されたとき、HAVING で特定の集計行だけをフィルタリングできます。
SQL(ROLLUP + HAVING)
-- ROLLUP で部門別 + 全体合計を生成
SELECT department_id, job_id,
       SUM(salary) AS total_salary,
       COUNT(*) AS emp_count
FROM employees
GROUP BY ROLLUP(department_id, job_id)
HAVING SUM(salary) >= 50000;   -- 合計 50000 以上のグループだけ表示

-- GROUPING 関数と組み合わせて小計行のみ抽出
SELECT department_id, job_id,
       SUM(salary) AS total_salary
FROM employees
GROUP BY ROLLUP(department_id, job_id)
HAVING GROUPING(job_id) = 1     -- job_id が集約された行 = 部門小計行
ORDER BY department_id;
HAVING + CASE 式
SQL(CASE 式を使った条件付き集計 + HAVING)
-- 「高給(10000以上)の社員が 3 名以上いる部門」を抽出
SELECT department_id,
       COUNT(CASE WHEN salary >= 10000 THEN 1 END) AS high_salary_count,
       COUNT(*) AS total_count
FROM employees
GROUP BY department_id
HAVING COUNT(CASE WHEN salary >= 10000 THEN 1 END) >= 3;

-- 「エラー率が 5% を超える月」を抽出
SELECT TO_CHAR(log_date, 'YYYY-MM') AS month,
       COUNT(*) AS total_requests,
       COUNT(CASE WHEN status_code >= 500 THEN 1 END) AS error_count,
       ROUND(
           COUNT(CASE WHEN status_code >= 500 THEN 1 END) * 100.0
           / COUNT(*), 2
       ) AS error_rate_pct
FROM access_log
GROUP BY TO_CHAR(log_date, 'YYYY-MM')
HAVING COUNT(CASE WHEN status_code >= 500 THEN 1 END) * 100.0
       / COUNT(*) > 5
ORDER BY month;
パフォーマンス最適化
| ルール | 説明 | 例 |
|---|---|---|
| 集計関数を使わない条件は WHERE に書く | WHERE で先にフィルタすれば GROUP BY の処理行数が減る | HAVING dept_id = 10 → WHERE dept_id = 10 に変更 |
| インデックスを活用する | WHERE 句の列にインデックスがあれば行フィルタが高速化 | WHERE status = ‘ACTIVE’ の status 列にインデックス |
| 不要な列を SELECT しない | GROUP BY の列数が増えるとソートコストが増加 | 必要な列だけ SELECT する |
| HAVING の集計関数を SELECT と統一する | HAVING と SELECT で同じ集計関数を使えばオプティマイザが最適化しやすい | SELECT COUNT(*) … HAVING COUNT(*) >= 5 |
SQL(NG と OK の比較)
-- NG: WHERE で書ける条件を HAVING に書いている
SELECT department_id, AVG(salary)
FROM employees
GROUP BY department_id
HAVING department_id IN (10, 20, 30)   -- 集計関数ではない
   AND AVG(salary) >= 5000;

-- OK: 行条件は WHERE、集計条件は HAVING に分離
SELECT department_id, AVG(salary)
FROM employees
WHERE department_id IN (10, 20, 30)    -- WHERE で先にフィルタ
GROUP BY department_id
HAVING AVG(salary) >= 5000;            -- 集計条件だけ HAVING に
実務パターン集
パターン(1): 重複データの検出
SQL(重複レコードの検出)
-- email が重複している行を検出
SELECT email, COUNT(*) AS dup_count
FROM employees
GROUP BY email
HAVING COUNT(*) >= 2
ORDER BY dup_count DESC;
パターン(2): 月次売上が目標未達の月を抽出
SQL(目標未達の月を抽出)
SELECT TO_CHAR(order_date, 'YYYY-MM') AS month,
       SUM(amount) AS monthly_sales
FROM orders
WHERE order_date >= DATE '2025-01-01'
GROUP BY TO_CHAR(order_date, 'YYYY-MM')
HAVING SUM(amount) < 1000000
ORDER BY month;
パターン(3): 一定期間注文がない顧客を検出
SQL(最終注文から N 日以上経過した顧客)
SELECT customer_id,
       MAX(order_date) AS last_order,
       TRUNC(SYSDATE - MAX(order_date)) AS days_since_last
FROM orders
GROUP BY customer_id
HAVING MAX(order_date) < SYSDATE - 90   -- 90 日以上注文なし
ORDER BY last_order;
パターン(4): 外れ値の検出(標準偏差)
SQL(平均から大きく外れた部門を検出)
-- 部門平均給与が全社平均の 2 倍以上、または 0.5 倍以下の部門
SELECT department_id,
       AVG(salary) AS dept_avg,
       (SELECT AVG(salary) FROM employees) AS company_avg
FROM employees
GROUP BY department_id
HAVING AVG(salary) > (SELECT AVG(salary) FROM employees) * 2
    OR AVG(salary) < (SELECT AVG(salary) FROM employees) * 0.5;
よくあるエラー
| エラー | 原因 | 対処 |
|---|---|---|
| ORA-00934 group function is not allowed here |
WHERE 句に集計関数(SUM, COUNT 等)を書いた | 集計条件は HAVING に移動する |
| ORA-00979 not a GROUP BY expression |
SELECT にグループ化されていない列がある | SELECT の列を GROUP BY に追加するか、集計関数で囲む |
| ORA-00904 invalid identifier |
HAVING で SELECT の別名(AS avg_sal)を使った | HAVING では別名は使えない。集計関数をそのまま書く(HAVING AVG(salary) >= 5000) |
HAVING で SELECT の列別名は使えない
Oracle では HAVING 句は SELECT より先に評価されるため、
Oracle では HAVING 句は SELECT より先に評価されるため、
HAVING avg_sal >= 5000 はエラーになります(avg_sal は SELECT で定義した別名)。HAVING AVG(salary) >= 5000 のように集計関数をそのまま書いてください。よくある質問
QWHERE と HAVING はどちらを使うべきですか?
A集計関数を使わない条件は WHERE、集計関数を使う条件は HAVING に書きます。WHERE で先に行を絞り込んだ方がパフォーマンスが良いため、行レベルの条件を HAVING に書くのは避けてください。
QHAVING だけで WHERE なしでも使えますか?
Aはい。WHERE なしで HAVING だけでも文法的に正しいです。ただし WHERE で絞り込める条件がある場合は、パフォーマンスのために WHERE も併用してください。
QGROUP BY なしで HAVING を使えますか?
Aはい。GROUP BY を省略するとテーブル全体が 1 つのグループとして扱われ、HAVING の条件を満たせば 1 行の集計結果が返り、満たさなければ 0 行が返ります。「テーブル全体の集計値が条件を満たすか」を判定するのに使えます。
QHAVING で SELECT の別名(AS avg_sal)を使うとエラーになります
AOracle では HAVING は SELECT より先に評価されるため、SELECT で付けた別名は使えません。
HAVING avg_sal >= 5000 ではなく HAVING AVG(salary) >= 5000 と集計関数をそのまま書いてください。(MySQL では別名が使えますが、Oracle / PostgreSQL / SQL Server では使えません)QHAVING にサブクエリは使えますか?
Aはい。
HAVING AVG(salary) > (SELECT AVG(salary) FROM employees) のようにサブクエリを条件値として使えます。「全社平均より高い部門」「最大件数と同じ件数のグループ」など、動的な閾値でフィルタリングする場合に便利です。QHAVING でウィンドウ関数(OVER 句)は使えますか?
Aいいえ。Oracle では HAVING 句にウィンドウ関数(RANK() OVER(…) 等)は使えません。ウィンドウ関数で計算した値をフィルタしたい場合は、サブクエリまたは CTE で先にウィンドウ関数を計算し、外側の WHERE でフィルタしてください。
まとめ
HAVING 句の要点をまとめます。
| やりたいこと | 書き方 |
|---|---|
| 集計結果でグループをフィルタ | GROUP BY col HAVING aggregate >= value |
| 行レベルのフィルタ | WHERE(集計関数不可。HAVING ではなく WHERE を使う) |
| WHERE + HAVING の併用 | WHERE で先に絞り → GROUP BY → HAVING で集計条件 |
| 複数の集計条件 | HAVING cond1 AND cond2 / HAVING cond1 OR cond2 |
| テーブル全体の集計値を判定 | SELECT aggregate FROM table HAVING aggregate >= value(GROUP BY なし) |
| 全社平均と比較 | HAVING AVG(col) > (SELECT AVG(col) FROM table) |
| 重複データの検出 | GROUP BY col HAVING COUNT(*) >= 2 |
| ROLLUP 小計行のフィルタ | HAVING GROUPING(col) = 1 |
| 条件付き集計のフィルタ | HAVING COUNT(CASE WHEN cond THEN 1 END) >= N |