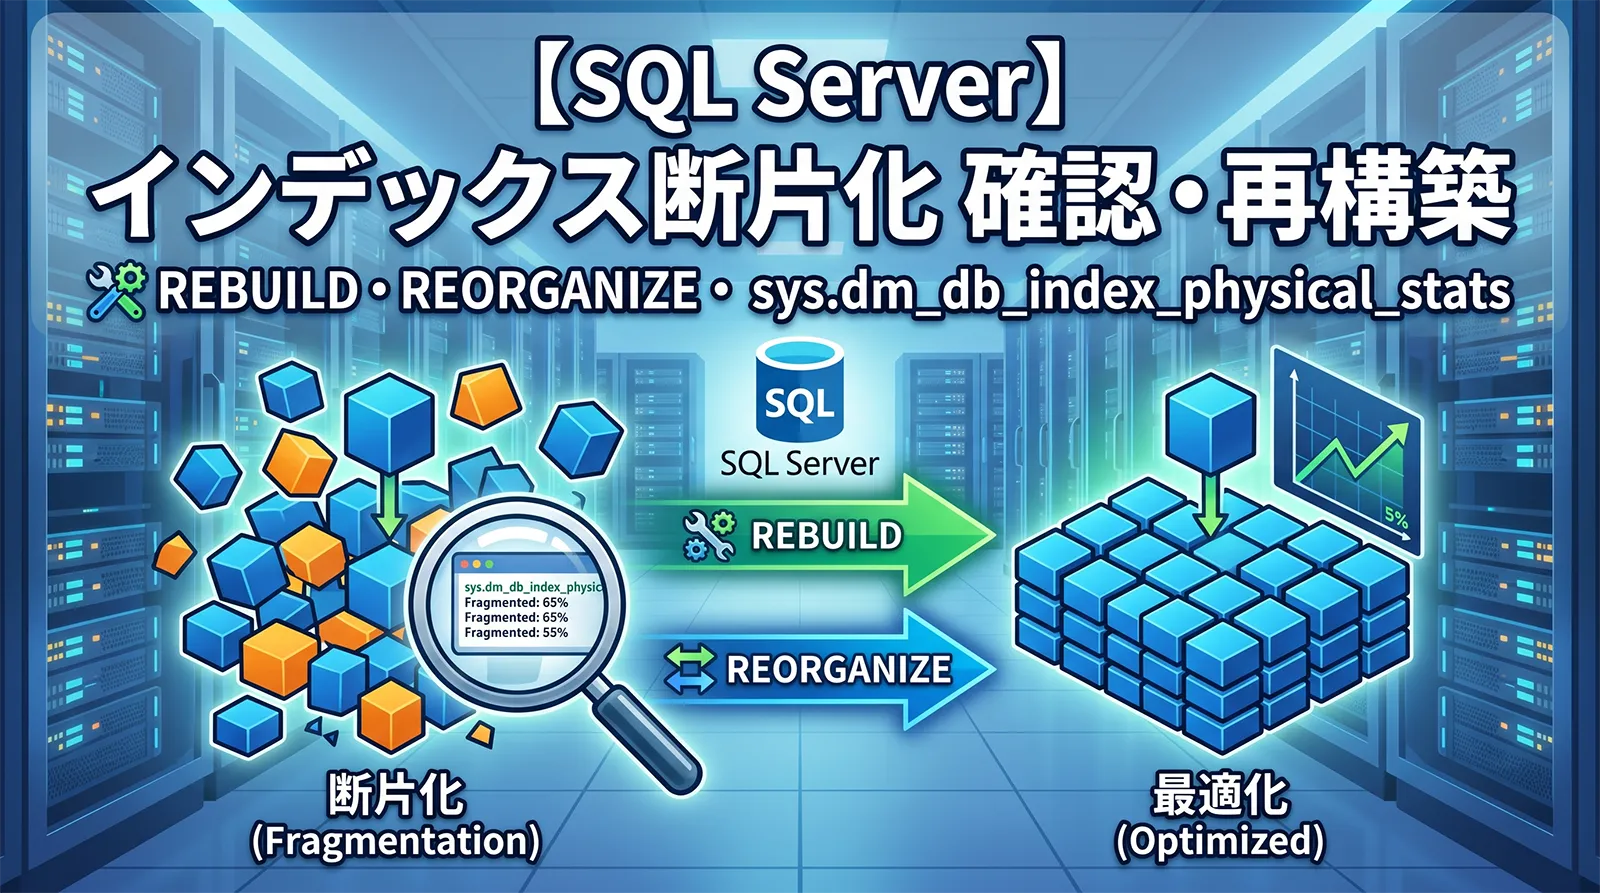
SQL Serverで「最近SQLが遅い」「インデックスを作っているのに読み取りが重い」と感じたとき、確認候補のひとつがインデックス断片化です。ただし、断片化率だけを見て機械的に REBUILD すればよいわけではありません。断片化、ページ密度、対象ページ数、実際のSQL性能、メンテナンス負荷を合わせて判断する必要があります。
この記事では、sys.dm_db_index_physical_stats で断片化を確認するSQL、REORGANIZE と REBUILD の違い、実行前後に見るべきポイント、やってはいけない運用パターンまで実務向けに整理します。
まず
sys.dm_db_index_physical_stats で avg_fragmentation_in_percent、avg_page_space_used_in_percent、page_count を確認します。小さいインデックスは断片化率が高く見えても効果が出にくいため除外します。軽い保守なら REORGANIZE、大きく作り直すなら REBUILD を検討しますが、固定の断片化率だけではなく、Query Storeや実行計画で実際に改善するかを確認してから運用に入れます。インデックス断片化とは
SQL Serverの行ストアインデックスでは、キー値の論理的な順序と、実際のページの物理的な順序がずれることがあります。これがインデックス断片化です。INSERT、UPDATE、DELETEが繰り返されるとページ分割や空き領域の偏りが発生し、断片化やページ密度の低下につながります。
断片化が問題になりやすいのは、インデックスの範囲スキャンや全体スキャンで多くのページを読むSQLです。一方、少数行だけをSeekするSQLでは、断片化率が高くても体感差が小さいことがあります。まずは実行計画や読み取り量を見て、対象SQLに効きそうかを確認します。
確認する指標
断片化を判断するときは、断片化率だけでなくページ密度も見ます。Microsoft Learnでも、インデックスメンテナンスの判断には断片化とページ密度の両方を考慮すると説明されています。
| 指標 | 意味 | 見る理由 |
|---|---|---|
avg_fragmentation_in_percent |
論理的なページ順序の乱れ | 範囲スキャンや全体スキャンのI/Oに影響しやすい |
avg_page_space_used_in_percent |
ページ密度。ページ内がどれくらい埋まっているか | 低いと同じデータを読むのに必要なページ数が増える |
page_count |
対象インデックスのページ数 | 小さいインデックスは保守しても効果が出にくい |
index_type_desc |
クラスタ化、非クラスタ化、列ストアなど | 行ストアと列ストアで見る指標や対処が変わる |
partition_number |
パーティション番号 | 大きな表では対象パーティションだけを保守できる |
データベース全体の断片化を確認するSQL
まずはデータベース内の行ストアインデックスを一覧で確認します。全ページを読む DETAILED は重くなりやすいため、最初は SAMPLED か LIMITED で全体感を見ます。
SELECT
    OBJECT_SCHEMA_NAME(ips.object_id) AS schema_name,
    OBJECT_NAME(ips.object_id) AS table_name,
    i.name AS index_name,
    i.type_desc AS index_type,
    ips.partition_number,
    ips.avg_fragmentation_in_percent,
    ips.avg_page_space_used_in_percent,
    ips.page_count,
    ips.alloc_unit_type_desc
FROM sys.dm_db_index_physical_stats(DB_ID(), NULL, NULL, NULL, 'SAMPLED') AS ips
JOIN sys.indexes AS i
    ON i.object_id = ips.object_id
   AND i.index_id = ips.index_id
WHERE ips.index_id > 0
  AND ips.alloc_unit_type_desc = 'IN_ROW_DATA'
ORDER BY ips.page_count DESC, ips.avg_fragmentation_in_percent DESC;
page_count が小さいものは、断片化率が高くても優先度を下げます。たとえば数十ページしかないインデックスは、断片化を解消しても読み取り量の改善が小さいことが多いです。
特定テーブルだけ詳しく確認する
対象テーブルが決まっている場合は、OBJECT_ID を使って絞り込みます。ただし、オブジェクト名の指定ミスで NULL になると、想定外に広い範囲を確認してしまうことがあります。先にIDを変数へ入れて、存在確認してから使うのが安全です。
DECLARE @object_id int = OBJECT_ID(N'dbo.Orders');

IF @object_id IS NULL
BEGIN
    THROW 50000, 'dbo.Orders が見つかりません。', 1;
END;

SELECT
    OBJECT_SCHEMA_NAME(ips.object_id) AS schema_name,
    OBJECT_NAME(ips.object_id) AS table_name,
    i.name AS index_name,
    ips.partition_number,
    ips.avg_fragmentation_in_percent,
    ips.avg_page_space_used_in_percent,
    ips.page_count
FROM sys.dm_db_index_physical_stats(DB_ID(), @object_id, NULL, NULL, 'DETAILED') AS ips
JOIN sys.indexes AS i
    ON i.object_id = ips.object_id
   AND i.index_id = ips.index_id
WHERE ips.index_id > 0
  AND ips.alloc_unit_type_desc = 'IN_ROW_DATA'
ORDER BY ips.avg_fragmentation_in_percent DESC;
DETAILED は全ページをスキャンするため、大きなテーブルでは検証環境や低負荷時間帯で使います。本番で定期実行するなら、まず SAMPLED で候補を絞るほうが扱いやすいです。
必要な権限と本番での注意
sys.dm_db_index_physical_stats は、指定したオブジェクトへの CONTROL 権限、またはデータベース全体を確認するための VIEW DATABASE STATE 権限が必要になることがあります。SQL Server 2022以降では、環境によって VIEW DATABASE PERFORMANCE STATE が必要になる場合もあります。
また、このDMVは指定したテーブルやビューに対してIntent-Sharedロックを取得します。通常は軽いロックですが、Always On可用性グループの読み取り可能セカンダリで実行する場合などは、REDO処理と競合してブロッキング要因になることがあります。大きなDBで全体スキャンする場合は、業務ピークを避けて実行します。
| 確認内容 | ポイント |
|---|---|
| 権限 | CONTROL、VIEW DATABASE STATE、VIEW DATABASE PERFORMANCE STATE を確認する |
| 実行モード | 本番の広範囲確認は LIMITED や SAMPLED から始める |
| 実行対象 | 全DB・全テーブルではなく、問題のあるDBやテーブルから確認する |
| 可用性グループ | 読み取り可能セカンダリでのブロッキングに注意する |
REORGANIZEとREBUILDの違い
SQL Serverの代表的なインデックス保守は REORGANIZE と REBUILD です。名前は似ていますが、動きと負荷が大きく違います。
| 操作 | 内容 | 特徴 |
|---|---|---|
REORGANIZE |
リーフレベルのページを並べ直し、ページを圧縮する | 比較的軽い。常にオンライン操作。統計情報は更新されない |
REBUILD |
インデックスを削除して作り直す | 断片化を広く解消し、行ストアインデックスの統計情報も更新される。負荷とログ量が大きい |
UPDATE STATISTICS |
統計情報を更新する | 断片化は解消しないが、実行計画の改善にはこちらで十分なことがある |
Microsoft Learnでは、インデックスメンテナンスの効果は断片化だけで判断せず、ワークロードごとに測定すべきだと説明されています。また、REBUILDで速くなったように見えるケースでも、実際には統計情報が更新された効果であることがあります。
使い分けの目安
よくある目安として、断片化率が低ければ何もしない、中程度なら REORGANIZE、高ければ REBUILD という考え方があります。ただし、これは出発点であって固定ルールではありません。ページ数、ページ密度、対象SQLの実行頻度、メンテナンス時間、ログ容量を合わせて判断します。
| 状態 | 候補 | 補足 |
|---|---|---|
| ページ数が少ない | 何もしない | 断片化率が高くても効果が小さいことが多い |
| 断片化が中程度 | REORGANIZE |
軽く並べ直したい場合に使う。実行後に統計情報更新も検討する |
| 断片化が高く、ページ密度も低い | REBUILD |
負荷・ログ・ブロッキングを考慮して低負荷時間帯に実行する |
| 実行計画の悪化が主因 | UPDATE STATISTICS |
断片化より統計情報が効いている可能性がある |
| 特定パーティションだけ悪い | パーティション単位の保守 | 全体ではなく悪い範囲だけを対象にする |
REORGANIZEの実行例
REORGANIZE は比較的軽い操作ですが、まったく負荷がないわけではありません。大きなインデックスでは時間がかかるため、実行タイミングは選びます。
ALTER INDEX IX_Orders_CustomerID_OrderDate
ON dbo.Orders
REORGANIZE;
テーブル上のすべてのインデックスを対象にする場合は ALL を使えます。ただし、本番では対象を絞らずに一括実行すると、想定以上に時間がかかることがあります。
ALTER INDEX ALL
ON dbo.Orders
REORGANIZE;
REORGANIZE では統計情報は更新されません。必要に応じて、対象インデックスや対象テーブルの統計情報を別途更新します。
UPDATE STATISTICS dbo.Orders IX_Orders_CustomerID_OrderDate;
REBUILDの実行例
REBUILD はインデックスを作り直すため、断片化解消効果は大きい一方で、CPU、I/O、ログ、空き容量を多く使います。オフラインREBUILDでは対象テーブルへのアクセスを長くブロックする可能性があります。
ALTER INDEX IX_Orders_CustomerID_OrderDate
ON dbo.Orders
REBUILD;
環境やエディションで利用できる場合は、ONLINE = ON を検討します。ただし、オンラインREBUILDでも最後に短いロックが必要になり、実行中は追加の更新負荷がかかります。
ALTER INDEX IX_Orders_CustomerID_OrderDate
ON dbo.Orders
REBUILD WITH (
    ONLINE = ON,
    SORT_IN_TEMPDB = ON,
    MAXDOP = 2
);
大きなインデックスでは、対応バージョンなら再開可能なREBUILDも選択肢になります。途中で一時停止・再開できるため、メンテナンス時間を分割しやすくなります。ただし、一時停止したまま放置すると、オンラインREBUILD中の追加負荷が残ることがあるため、完了しないなら中止まで含めて運用手順を決めます。
ALTER INDEX IX_Orders_CustomerID_OrderDate
ON dbo.Orders
REBUILD WITH (
    ONLINE = ON,
    RESUMABLE = ON,
    MAX_DURATION = 60 MINUTES,
    MAXDOP = 2
);

-- 一時停止中の操作を再開する
ALTER INDEX IX_Orders_CustomerID_OrderDate
ON dbo.Orders
RESUME;

-- 完了しない場合は中止する
ALTER INDEX IX_Orders_CustomerID_OrderDate
ON dbo.Orders
ABORT;
SORT_IN_TEMPDB = ON は並べ替え作業を tempdb に逃がす指定です。tempdbに十分な空き容量がないと逆に失敗や負荷増加につながります。
SQL Serverでtempdbが肥大化する原因と確認方法
パーティション単位で保守する
パーティションテーブルでは、全体ではなく特定パーティションだけを対象にできます。月次や日次で古いパーティションがほとんど変わらない設計なら、更新が多い新しいパーティションだけを保守するほうが現実的です。
ALTER INDEX IX_Orders_CustomerID_OrderDate
ON dbo.Orders
REBUILD PARTITION = 12 WITH (ONLINE = ON);
パーティション単位で見る場合は、sys.dm_db_index_physical_stats の partition_number を必ず確認します。全体平均だけを見ると、悪いパーティションや問題のないパーティションを見誤ります。
実行前に確認すること
本番でREBUILDやREORGANIZEを実行する前に、最低限次の点を確認します。特にREBUILDはトランザクションログを大きく使うことがあるため、ログ容量とバックアップ運用も見ておきます。
| 確認項目 | 理由 |
|---|---|
| 対象インデックスのサイズ | REBUILD時に十分な空き容量が必要になるため |
| トランザクションログ容量 | 大きなREBUILDでログが急増することがあるため |
| tempdb容量 | SORT_IN_TEMPDB や並べ替え処理で使うため |
| 実行時間帯 | CPU、I/O、ロックの影響を受けるため |
| 復旧モデルとログバックアップ | ログ肥大化やディスク枯渇を避けるため |
| オンライン操作の可否 | バージョン、エディション、インデックス種別で制約があるため |
SQL Serverでトランザクションログがいっぱいになる原因と対処法
ログとtempdbは、実行前に数値で確認しておきます。空きが少ない状態でREBUILDを始めると、途中で失敗したり、他の処理まで巻き込んで遅くなったりします。
-- 対象DBのトランザクションログ使用状況
SELECT
    DB_NAME(database_id) AS database_name,
    total_log_size_mb,
    used_log_space_mb,
    used_log_space_in_percent
FROM sys.dm_db_log_space_usage;

-- tempdbファイルの空き容量
SELECT
    name,
    type_desc,
    size * 8.0 / 1024 AS size_mb,
    FILEPROPERTY(name, 'SpaceUsed') * 8.0 / 1024 AS used_mb,
    (size - FILEPROPERTY(name, 'SpaceUsed')) * 8.0 / 1024 AS free_mb
FROM tempdb.sys.database_files;
実行中の負荷を確認するSQL
大きなインデックス保守を実行すると、待機、ブロッキング、CPU、I/Oが増えることがあります。実行中は sys.dm_exec_requests で進行中のコマンドを確認します。
SELECT
    r.session_id,
    r.command,
    r.status,
    r.percent_complete,
    r.wait_type,
    r.wait_time,
    r.blocking_session_id,
    r.cpu_time,
    r.logical_reads,
    r.writes,
    t.text AS running_sql
FROM sys.dm_exec_requests AS r
OUTER APPLY sys.dm_exec_sql_text(r.sql_handle) AS t
WHERE r.session_id <> @@SPID
ORDER BY r.cpu_time DESC;
実行前後で効果を測る
インデックス保守は、実行して終わりではありません。本当に速くなったか、読み取り量が減ったか、実行計画が変わったかを確認します。
SET STATISTICS IO ON;
SET STATISTICS TIME ON;

-- 保守前後で同じ条件・同じパラメータで比較する
SELECT
    OrderID,
    CustomerID,
    OrderDate,
    TotalAmount
FROM dbo.Orders
WHERE CustomerID = 100
  AND OrderDate >= '2026-05-01'
  AND OrderDate <  '2026-06-01';

SET STATISTICS TIME OFF;
SET STATISTICS IO OFF;
Query Storeが有効なら、保守前後の平均実行時間、読み取り量、実行計画の変化を追いやすくなります。断片化保守で効果があったのか、統計情報更新で効果が出たのかを分けて見ることも大切です。
断片化だけで解決しないケース
インデックスをREBUILDしてもSQLが速くならないことは普通にあります。原因が断片化ではなく、SQLの書き方、暗黙変換、統計情報、パラメータ値の偏り、Key Lookup、tempdb spillにある場合です。
| 症状 | 疑う原因 | 関連記事 |
|---|---|---|
| インデックスが使われない | 暗黙変換、関数、LIKE、列順の不一致 | インデックスが使われない原因 |
| Key Lookupが大量に出る | 取得列がインデックスに足りない | カバリングインデックスとは |
| 実行計画が日によって変わる | パラメータスニッフィング、統計情報の偏り | パラメータスニッフィングとは |
| SortやHash Matchで重い | メモリ不足、tempdb spill、結合順序 | tempdbが肥大化する原因 |
やってはいけない運用
インデックスメンテナンスは、定期実行の自動化と相性がよい一方で、雑に組むと本番負荷を増やします。特に、全DB・全テーブル・全インデックスを毎晩REBUILDするような運用は避けます。
| NG運用 | 問題 | 改善案 |
|---|---|---|
| 毎晩すべてREBUILD | CPU、I/O、ログ、ブロッキングが大きい | 対象インデックスを絞る |
| 断片化率だけで判断 | 効果の薄い小さなインデックスまで保守する | page_count、ページ密度、実SQL性能も見る |
| REORGANIZE後に統計情報を見ない | 統計情報が古いまま残る | 必要に応じてUPDATE STATISTICSを実行する |
| ログ容量を見ずにREBUILD | トランザクションログがいっぱいになる | ログ容量とバックアップを先に確認する |
| 効果測定しない | 本当に必要な保守か判断できない | Query StoreやSTATISTICS IOで前後比較する |
自動化する場合の安全な流れ
定期メンテナンスに組み込む場合は、いきなり実行するのではなく、候補を出す処理と実行する処理を分けます。まずは候補一覧を出力して、対象件数・推定負荷・業務時間帯への影響を確認できるようにします。
SELECT
    OBJECT_SCHEMA_NAME(ips.object_id) AS schema_name,
    OBJECT_NAME(ips.object_id) AS table_name,
    i.name AS index_name,
    ips.partition_number,
    ips.avg_fragmentation_in_percent,
    ips.avg_page_space_used_in_percent,
    ips.page_count,
    CASE
        WHEN ips.page_count < 1000 THEN 'SKIP_SMALL_INDEX'
        WHEN ips.avg_fragmentation_in_percent >= 30 THEN 'CONSIDER_REBUILD'
        WHEN ips.avg_fragmentation_in_percent >= 10 THEN 'CONSIDER_REORGANIZE'
        ELSE 'NO_ACTION'
    END AS maintenance_candidate
FROM sys.dm_db_index_physical_stats(DB_ID(), NULL, NULL, NULL, 'SAMPLED') AS ips
JOIN sys.indexes AS i
    ON i.object_id = ips.object_id
   AND i.index_id = ips.index_id
WHERE ips.index_id > 0
  AND ips.alloc_unit_type_desc = 'IN_ROW_DATA'
ORDER BY ips.page_count DESC, ips.avg_fragmentation_in_percent DESC;
上のSQLの閾値はあくまで候補を分けるための例です。Microsoft Learnでも、固定の断片化率やページ密度だけで判断せず、ワークロードごとの性能改善とメンテナンスコストを測ることが重要だと説明されています。本番では、候補をログに残し、対象件数が多すぎる日は一部だけ実行するなど、停止しやすい設計にします。
よくある質問
断片化率が高ければ必ずREBUILDすべきですか?
必ずではありません。小さいインデックスや、Seek中心で少数ページしか読まないSQLでは効果が小さいことがあります。断片化率、ページ密度、page_count、対象SQLの読み取り量を合わせて判断します。
REBUILDすれば統計情報更新は不要ですか?
行ストアインデックスのREBUILDでは、そのインデックスの統計情報が更新されます。ただし、すべての列統計や別の統計情報まで十分とは限りません。REORGANIZEでは統計情報は更新されないため、必要に応じて UPDATE STATISTICS を実行します。
ONLINE = ONなら本番中に実行しても安全ですか?
安全と言い切ることはできません。オンラインREBUILDでもCPU、I/O、ログ、最後の短いロック、更新処理への追加負荷があります。低負荷時間帯で実行し、進行中の待機やブロッキングを監視します。
フィルファクターを下げれば断片化を防げますか?
更新が多くページ分割が頻発するインデックスでは効果がある場合があります。ただし、フィルファクターを下げるとページ密度も下がり、読むページ数が増えます。むやみに下げず、ページ分割や更新パターンを確認してから設定します。
参考
sys.dm_db_index_physical_stats – Microsoft Learn
まとめ
SQL Serverのインデックス断片化は、sys.dm_db_index_physical_stats で確認できます。ただし、avg_fragmentation_in_percent だけで判断せず、avg_page_space_used_in_percent、page_count、対象SQLの読み取り量、実行計画を合わせて見ます。
軽い保守なら REORGANIZE、作り直しが必要なら REBUILD を検討します。ただし、REBUILDはCPU、I/O、ログ、空き容量、ブロッキングの影響が大きいため、低負荷時間帯に対象を絞って実行し、Query Storeや STATISTICS IO で効果を確認しましょう。